As automações podem escalar comunidades de forma eficiente ao assumirem tarefas repetitivas, permitindo que o toque humano seja focado na estratégia e na conexão real. Segundo o vídeo, o segredo não é substituir o humano, mas sim usar a tecnologia como um auxiliar para otimizar o tempo e a qualidade da experiência do membro.
Para escalar sem perder a essência humana, as fontes sugerem os seguintes pontos:
1. Definição Prévia de Processos
A automação só é eficaz se o processo estiver bem estruturado. Automatizar a bagunça gera fricção e gargalos. Antes de implementar tecnologia, é fundamental definir as funções e fluxos (entrada, manutenção e saída) para que a automação sirva como um facilitador do trabalho já existente.
2. Automação do "Trabalho de Base" e Repetitivo
A tecnologia deve cuidar do que é mecânico, liberando as pessoas para o que é essencial. Isso inclui:
- Gestão de Acessos e Onboarding: Automatizar a liberação de espaços após a compra e o envio de notificações de boas-vindas garantem uma experiência fluida e imediata para o cliente.
- Lembretes e Notificações: Usar automações para avisar sobre eventos e encontros recorrentes ajuda a criar o hábito de uso do produto sem demandar esforço manual constante da equipe.
- Envio de Certificados: Automatizar a entrega de certificados pode ser um diferencial de entrega em nichos específicos.
3. Inteligência Artificial para Escalar a "Escuta"
A IA permite que o gestor da comunidade "ouça" milhares de membros ao mesmo tempo através de:
- Análise de Dados Qualitativos: Extrair conteúdos da comunidade, tratar esses dados e gerar relatórios sobre o que está sendo falado e quais são as dúvidas mais frequentes.
- Moderação Assistida: Em vez de apenas banir usuários, a IA pode notificar um moderador humano sobre comportamentos específicos em comunidades muito ativas, garantindo que nada passe despercebido.
- Curadoria de Conteúdo: Criar resumos automáticos de aulas ao vivo ou até mini-podcasts semanais com base no que foi discutido na comunidade, mantendo os membros informados de forma prática.
4. Personalização Tecnológica
É possível manter a "aparência humana" mesmo com automações. Exemplos citados incluem o uso de áudios com a voz do especialista e o nome customizado do lead/membro em mensagens de WhatsApp, o que gera dopamina e uma sensação de atenção individualizada, aumentando a conversão e o engajamento.
5. O Equilíbrio entre Tecnologia e Acolhimento
O toque humano deve permanecer em situações extraordinárias e no direcionamento estratégico. Enquanto a automação lida com o suporte repetitivo (como dúvidas de FAQ), o humano entra para resolver problemas complexos e oferecer acolhimento real, especialmente nos primeiros dias de jornada do membro. A combinação de automação para ativação e acolhimento humano para retenção é o que gera resultados sustentáveis a longo prazo.
Se você desejar, posso criar um relatório personalizado detalhando um plano de implementação dessas automações para o seu caso ou gerar um quiz para testar seus conhecimentos sobre estratégias de escala em comunidades. Como prefere prosseguir?

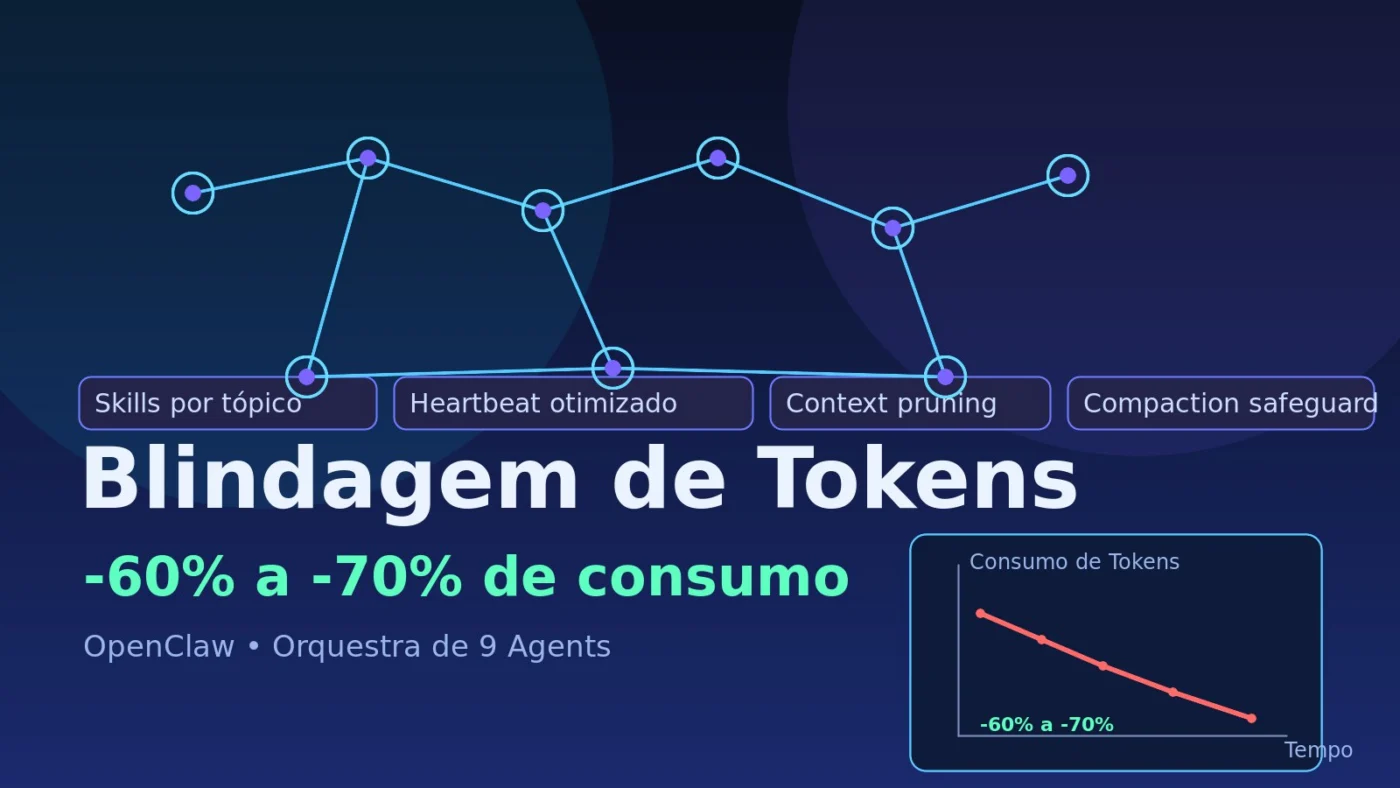
Se você opera automações com multi-agents, já sabe: token é dinheiro e limite de provider pode parar operação do nada.
A boa notícia é que dá pra reduzir consumo de forma agressiva sem desmontar qualidade.
Neste case, aplicamos blindagem em uma orquestra com 9 agents no OpenClaw e consolidamos uma redução real de ~60% a ~70% no consumo/contexto operacional.
Cenário inicial
Orquestra com 9 agents especializados (main + 8 secundários), com:
• alto volume de contexto injetado por turno,
• risco de crescimento silencioso de consumo,
• e exposição a travas de rate limit.
Nosso objetivo foi criar uma camada de proteção que funcionasse mesmo se o cenário “grátis” mudar.
O que mais queimava tokens
Mapeamos 5 vazamentos principais:
- Bootstrap pesado em todo turno (AGENTS.md, MEMORY.md grandes).
- Skills demais para quem não precisava delas.
- Heartbeats desnecessários em agents secundários.
- Histórico de grupo alto aumentando contexto injetado.
- Ausência de blindagem mais rígida de contexto (pruning + compaction).
O que aplicamos (na prática)
-
Compressão de arquivos estáticos (sem perder regra crítica)
• AGENTS.md (main): 8.9KB → 2.2KB (-76%)
• MEMORY.md (main): 6.7KB → 1.5KB (-77%)
Detalhes pesados foram movidos para arquivo de referência sob demanda (memory/infra-credenciais.md), em vez de ficar injetando tudo sempre.
-
Skills por especialidade/tópico (escopo mínimo)
Em vez de deixar “tudo para todos”, cada agent/tópico ficou só com o necessário:
• Sentinel → infra/healthcheck
• Catalyst → marketing/growth
• Chroma → design/copy
• Scribe → docs/pdf
• Archivist → sem skills extras (só tools nativos)
Para Nexus/Orion (uso por spawn), a regra foi fixada em AGENTS.md do workspace:
“Use apenas estas skills.” -
Heartbeat com governança
• Secundários: 0m (desativado)
• Main: ativo
• Janela ativa: 08:00–23:00 (BRT)
Isso removeu chamadas automáticas com baixo retorno e reduziu ruído operacional.
-
Blindagem de contexto no sistema
Aplicamos no config:
• contextPruning: cache-ttl (5m)
• compaction: safeguard + memoryFlush
• thinkingDefault: low
• historyLimit: 30 (grupo/telegram)
• bootstrapTotalMaxChars: 12000
Tradução prática: menos inchaço, menos repetição inútil e mais previsibilidade de custo.
-
Continuidade sem inflar prompt (amnesia-proof)
Regra de log obrigatório com evidência:
data/hora - ocorrência - ação - status - persiste? - evidênciaCom isso:
• diário em memory/YYYY-MM-DD.md,
• e consolidação de decisões permanentes em MEMORY.md.
Memória durável sem virar “lixo caro” no prompt.
Resultado consolidado
Economia real estimada (conservadora)
• Main: ~2.9k tokens a menos por turno (só em bootstrap comprimido)
• Agents de tópico: ~3k a ~4k tokens a menos por turno (com skills filtradas)
• Operação total: ~60% a ~70% de redução no consumo/contexto
Lições para quem roda automação com IA
- Prompt bonito não substitui arquitetura.
- Blindagem real vem de config/sistema, não de “frases de rate limit” no system prompt.
- Escopo mínimo por agent é um dos maiores ganhos de custo.
- Heartbeat sem propósito vira sangria de token.
- Token economy é disciplina de engenharia.
Checklist rápido (replicável)
• [ ] Comprimir AGENTS.md e MEMORY.md
• [ ] Mover detalhes pesados para memória sob demanda
• [ ] Filtrar skills por agent/tópico
• [ ] Cortar heartbeat onde não gera valor
• [ ] Definir janela de heartbeat
• [ ] Ativar pruning + compaction safeguard
• [ ] Reduzir historyLimit de grupos
• [ ] Formalizar protocolo amnesia-proof com evidência
Conclusão
Se você opera multi-agents em produção, otimizar token não é “nice to have”.
É sobre sobrevivência operacional, previsibilidade de custo e continuidade de entrega.
Blindar agora é o que evita apagar incêndio depois.

Essa extensão VS Code dá visibilidade para o que está em arquivos .md e .json instruindo e modulando o comportamento da IA. Também gera notificações, gera kanban, mostra os dados de forma mais prática da configuração do agente de ia da IDE.
https://open-vsx.org/extension/junio-de-almeida-vitorino/ai-agent-ide-context-sync-vscode
https://www.clawsecure.ai/
⭐️⭐️⭐️⭐️⭐️ 915 stars e contando!
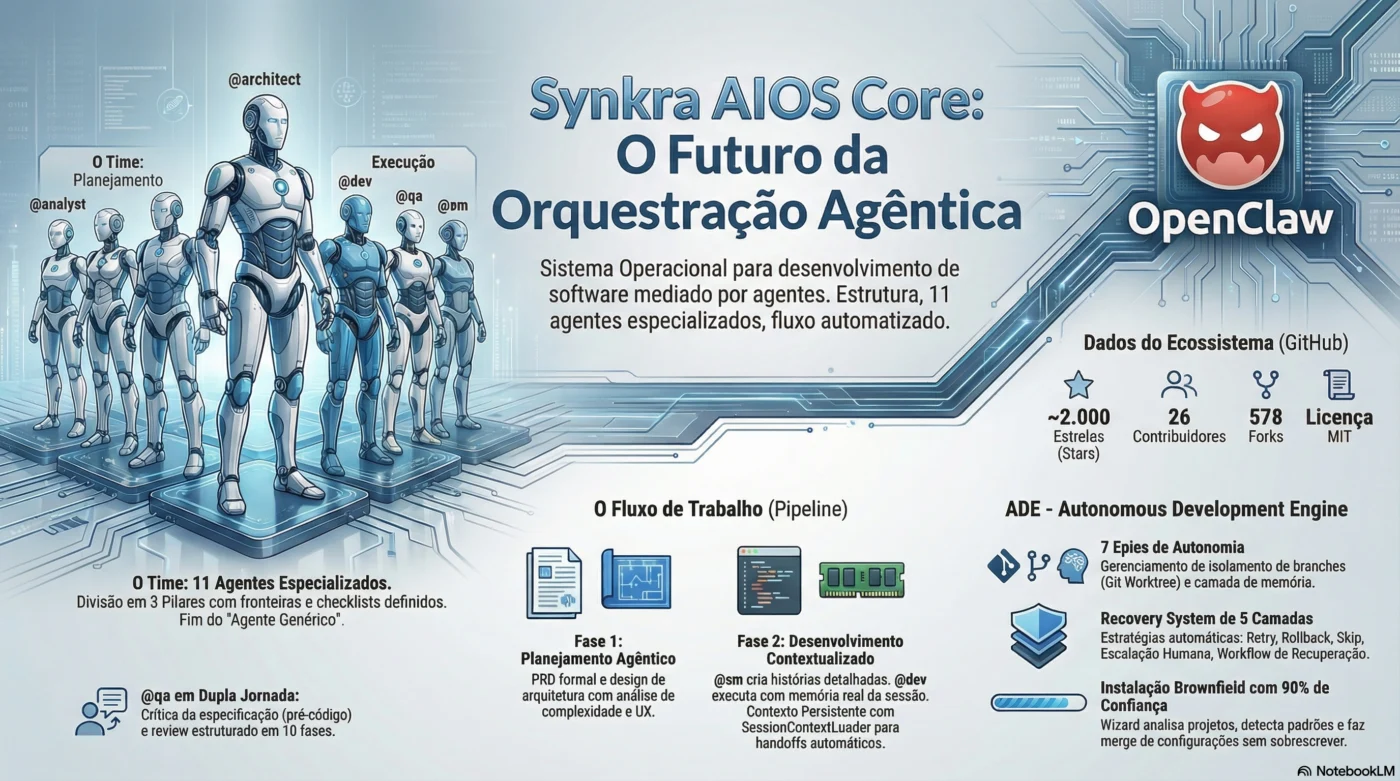
Enquanto OpenClaw ainda é "um agente bom", o AIOS Core (a trending do momento!) orquestra nativamente 11 agentes em um time ágil completo. Do PRD ao deploy testado, sem perda de contexto, sem inconsistências.
É uma estrutura ágil completa rodando SEM gastar uma fortuna. O futuro do desenvolvimento agêntico chegou.
O Que É o AIOS Core
O Synkra AIOS Core (v4.2.x, MIT, ~915 stars, trending fevereiro 2026) não é chatbot, não é copilot, não é plugin de IDE.
É um sistema operacional de orquestração agêntica que implementa o ciclo completo de desenvolvimento com agentes especializados que se comunicam, mantêm contexto compartilhado e seguem fluxo ágil real. TypeScript/Node.js, roda como pacote npm, Node.js >=18, MIT no core.
A promessa prática: você escolhe um objetivo, ativa um team, roda playbooks, e o sistema gera entregáveis + evidência — não opiniões vagas.
Os 11 Agentes: Papéis Claros, Outputs Claros
Em vez de um agente genérico tentando ser tudo, o AIOS trabalha com papéis definidos, comandos próprios e checklists por função.
Orquestração
Agente O Que Faz@aios-master
Coordenação central e meta-desenvolvimento do framework
@aios-orchestrator
Gerencia workflows e handoffs entre agentes
Planejamento
Agente O Que Faz Skills@analyst
Pesquisa domínio, levanta requisitos, analisa dependências
*research-deps, *extract-patterns
@pm
Prioriza features, escreve PRD
*gather-requirements, *write-spec
@architect
Design técnico, mapeamento de codebase
*assess-complexity, *create-plan, *map-codebase
@ux-expert
Usabilidade, fluxos de usuário
Análise UX
@qa
Crítica de spec antes de qualquer código
*critique-spec
Execução
Agente O Que Faz Skills@po
Gerencia backlog, aceita/rejeita entregas
Priorização
@sm
Cria histórias hiperdetalhadas, gerencia sprints
Stories executáveis
@dev
Implementa com contexto completo
*execute-subtask, *rollback, *apply-qa-fix
@qa
Review em 10 fases no ciclo de execução
*review-build, *request-fix, *verify-fix
O Fluxo em Duas Fases
Fase 1 — Planejamento Agêntico
@analyst pesquisa e cria briefing → @pm escreve PRD → @architect define stack e arquitetura → @ux-expert contribui com usabilidade → @qa critica a spec antes de existir uma linha de código.
Resultado: documentação real — PRD + arquitetura detalhados e revisados — não um prompt numa caixa de texto.
Fase 2 — Desenvolvimento Contextualizado
@sm transforma planos em histórias markdown com status, assignee, sprint e acceptance criteria → @dev executa subtasks com contexto completo → @qa roda review em 10 fases → bug encontrado: @qa solicita fix → @dev aplica → @qa verifica. Loop limpo e rastreável.
O Sistema de Contexto: O Diferencial Real
Story Files (docs/stories/): cada task vira markdown estruturado — fonte da verdade do trabalho, não conversa que some.
Session State (.aios/session-state.json): armazena último agente ativo, últimos 10 comandos, workflow ativo e story atual em tempo real.
SessionContextLoader: quando um agente novo assume, recebe briefing automático — "Continuando do @dev que rodou há 7 minutos. Última ação: validate-story-draft." Zero re-explicação.
SuggestionEngine: sugere próximos passos alinhados com os acceptance criteria da story atual, sem recomendar o que já foi feito.
Na prática: o @qa que assume após o @dev já sabe o que foi feito, qual a story e o que testar. O handoff é automático e informado.
O Motor Autônomo (ADE): 7 Epics
Epic Nome O Que Faz 1 Worktree Manager Isola cada story em Git worktree separado — sem conflitos de branch 2 Migration Migração automática de formatos legados 3 Spec Pipeline Requisitos de alto nível → specs executáveis com critérios claros 4 Execution Engine Executa em 13 steps com auto-crítica 5 Recovery System 5 estratégias automáticas quando algo falha 6 QA Evolution Review em 10 fases progressivas 7 Memory Layer Aprende padrões e erros anteriores (Pro)O Recovery System em detalhe: quando falha, classifica o erro e escolhe automaticamente entre Retry (erros transientes), Rollback + Retry (erros de estado), Skip (dependência não-crítica), Escalar pra Humano ou Recovery Workflow completo. O StuckDetector identifica loops e muda de estratégia. Engenharia real, não try-catch genérico.
Os Teams: Complexo Por Baixo, Simples Por Cima
Team = agentes + workflows recomendados. Em vez de "qual agente chamo?", você escolhe o time certo pro problema.
Team Use Para Entrega All Diagnóstico rápido, gargalo desconhecido Visão completa, plano de ataque Fullstack Produto end-to-end do zero PRD, arquitetura, backlog, execução, QA IDE Minimal Cadência diária enxuta (PO→SM→Dev→QA) Stories pequenas e frequentes No UI Backend, APIs, integrações, dados Arquitetura, contratos, qualidade QA-Focused Elevar qualidade antes de PR/merge/deploy Gates, relatórios, lista de riscos Executive Directorate Governança executiva, prioridades, tradeoffs Diretivas, cadência semanalTimes que construí:
Team Use Para Entrega DG Marketing Motor de demanda (RevOps, Paid, CRM, Copy, UX) Plano semanal, experimentos, scoreboard Autonomous Paid Media Paid media como sistema (ops + automação + analytics) Operating model, automações, loops de otimizaçãoUse Cases em 24h: Inputs, Outputs e Por Que Fica Fácil
Demand Gen: Pipeline-First, Semana a Semana
Inputs: meta semanal, ICP + oferta, capacidade do time e canais.
Outputs: weekly operating plan com donos e prazos, scoreboard de métricas + ritual de review, lista explícita de cortes e realocações.
Por que funciona: @dg-cmo orquestra o ciclo com comandos padronizados — sem reinventar a reunião toda semana.
Paid Media: Campanha Como Engenharia
Inputs: oferta + criativos + público, objetivo de conversão, budget e janela de aprendizagem.
Outputs: campanhas reproduzíveis (config-driven), catálogo local para operação rápida, relatórios para decidir (não medir vaidade), control plane para auditoria.
Por que funciona: a skill vira workflow guiado e repetível com guardrails — não operação ad hoc.
CRM e Lifecycle
Inputs: stages + handoffs, triggers + mensagens por etapa, definição de MQL/SQL.
Outputs: automações de lifecycle, auditoria de qualidade de dados, lead scoring e ajustes por performance.
Analytics: KPI Como Sistema
Inputs: definições de KPI + fonte, janela, meta e dono de cada métrica.
Outputs: modelo de KPI, rotina de diagnóstico (funil, variância, gargalos), backlog priorizado por impacto.
Conteúdo e Criativos
Inputs: tema + promessa + persona, formato (carrossel, vídeo, áudio, deck), objetivo.
Outputs: carrosséis com narrativa e hierarquia, vídeos (t2v/i2v), áudio multi-speaker, decks e materiais de aula.
Comunidade: Discord Operacional
Inputs: objetivo + rotinas da comunidade, regras de moderação.
Outputs: automações de mensagens, canais, roles e webhooks via MCP server dedicado.
Squads: Agentes Para Além de Dev
Squads são equipes de agentes para qualquer domínio. Cada squad tem config.yaml, agents/, tasks/, templates/ e checklists/. Você cria para o seu domínio específico — a estrutura é a mesma, o conteúdo é seu.
Domínios já mapeados: Marketing (copy, campanha, conteúdo), Educação (currículo, avaliação, planejamento pedagógico), Negócios (mercado, modelagem financeira, estratégia), Wellness (protocolos, análise de dados de saúde).
Observabilidade: Prova de Execução, Não de Intenção
- Quadro de tarefas com estados explícitos: fila, em progresso, bloqueado, feito, falhou
- Timeline de eventos com timestamp: o que aconteceu, quando, com qual agente
- Artifacts anexos: documentos e outputs vinculados à task que os gerou
- Modo de simulação para aula e demo — ciclo completo sem tocar em produção
Execução como sistema verificável, não como esperança.
Análise Honesta
O que impressiona:
O sistema de contexto funciona. Story files + session state + SessionContextLoader resolve o problema real de memória entre agentes. O Recovery System é comportamento implementado, não abstração. A instalação brownfield faz merge em vez de sobrescrever — respeita o projeto existente. Squads abrem o sistema para qualquer domínio. CLI first de verdade facilita automação e integração em pipelines.
O que requer atenção:
Experiência completa vive no Claude Code — Cursor e Copilot perdem automações de handoff. Curva de aprendizado real: 11 agentes, 7 Epics, dezenas de comandos. Ecossistema jovem (~915 stars, atividade concentrada). Memory Layer persistente e integrações enterprise (Jira, Linear, Notion) são Pro, só para membros do AIOS Cohort Advanced.
A nossa preocupação é ter qualidade, velocidade mas também economizar os tokens.
Token é a moeda de quem trabalha com desenvolvimento com IAs e sempre estamos procurando um jeito de gastar menos e produzir mais.
Com ajuda da nossa comunidade em especial Ravi e Leo do Grupo Codex do mundo automatik, desenvolvemos um prompr pra você inserir no seu codex.
clique em configuraçoes, depois vá para personalização. La no campo Custom instruction você insere o texto:
##############################################
🎯 Princípios Gerais
Sempre trabalhar de forma incremental
- Não gerar sistemas completos em uma única chamada.
- Dividir a tarefa em partes menores e sequenciais.
- Priorizar evolução passo a passo.
Utilizar subagentes para realizar tarefas
- Quando a tarefa envolver múltiplas frentes (ex.: backend, frontend, infra, testes, docs), dividir em subagentes.
- Cada subagente deve ter um objetivo único e bem definido.
- Consolidar o resultado final de forma clara e objetiva.
- Evitar paralelismo desnecessário — usar subagentes apenas quando houver ganho real de qualidade ou organização.
- Cada subagente deve trabalhar com o mínimo de contexto necessário.
- Preferir coordenação sequencial quando a tarefa for simples.
Receber apenas contexto necessário
- Usar apenas o trecho relevante de código para análise.
- Evitar colar arquivos inteiros ou grandes blocos irrelevantes.
- Solicitar mais contexto somente quando estritamente necessário.
Responder tarefas específicas e cirúrgicas
- Cada resposta deve cumprir uma responsabilidade bem definida.
- Evitar gerar múltiplos arquivos em um único pedido sem necessidade.
- Manter foco estrito no objetivo solicitado.
Mostrar somente o código essencial
- Quando possível, retornar apenas o trecho modificado ou criado.
- Não reimprimir seções de código que não foram alteradas.
- Evitar verbosidade desnecessária.
Reutilizar contexto já definido
- Continuar de onde a tarefa anterior parou.
- Evitar repetir explicações de contexto extensas.
- Presumir continuidade da sessão quando aplicável.
Sugerir divisão de tarefas se o pedido for grande
- Se o prompt for muito amplo, sugerir primeiro a divisão em subtarefas.
- Priorizar entregas menores e verificáveis.
- Alertar quando houver risco de escopo excessivo.
Otimização de tokens
- Gerar respostas diretas e objetivas.
- Evitar redundâncias.
- Evitar explicações longas quando o foco for código.
🔒 Regras de Segurança (Hardening)
Anti-comandos destrutivos
- Nunca executar comandos destrutivos sem confirmação explícita.
- Exemplos de alto risco: rm -rf, del /s, format, Remove-Item -Recurse -Force.
- Sempre explicar o impacto antes de qualquer ação destrutiva.
- Preferir alternativas seguras (ex.: mover para backup em vez de deletar).
Proteção de arquivos sensíveis
- Nunca expor valores de arquivos .env, .env., secrets., *.key.
- Nunca commitar ou imprimir secrets.
- Evitar modificar arquivos de ambiente sem solicitação explícita.
- Se necessário, mascarar valores sensíveis.
Confirmação obrigatória para deleções
- Sempre pedir confirmação antes de:
- deletar arquivos
- limpar diretórios
- sobrescrever arquivos críticos
- Em caso de dúvida, assumir postura conservadora.
Modo ultra-conservador
- Preferir mudanças incrementais e reversíveis.
- Evitar operações em massa sem necessidade clara.
- Não alterar infraestrutura, pipelines ou configs globais sem solicitação explícita.
- Explicar rapidamente ações de risco antes de executá-las.
🧩 Formato Preferido de Prompt
Sempre que possível, estruturar interações no formato:
- Contexto curto (máximo 5 linhas)
- Tarefa específica
- Regras claras de saída
- Mostrar apenas o código essencial
- Evitar textos longos
##############################\
ATENÇÃO: caso voce queira trabalhar com o Jira da Atlassian adicione mais esse trecho:
##############################
🗂️ Integração com Jira
Trabalhar orientado a Issue
- Cada tarefa deve corresponder a uma issue do Jira.
- Não executar múltiplas histórias em uma única resposta.
- Se a issue estiver ampla demais, sugerir subdivisão antes de iniciar.
Respeitar escopo da Issue
- Implementar apenas o que está descrito no ticket.
- Não expandir escopo sem solicitação explícita.
- Não antecipar tarefas de outras issues.
Classificação de tamanho
-
Se a tarefa parecer:
- 🟢 Pequena → executar normalmente.
- 🟡 Média → sugerir divisão opcional.
- 🔴 Grande → obrigatoriamente propor divisão antes de implementar.
Atualização incremental
-
Entregar mudanças que possam ser:
- testadas isoladamente
- revisadas facilmente
- revertidas com segurança
Não assumir backlog implícito
- Não criar funcionalidades “porque parecem necessárias”.
- Trabalhar estritamente com base na descrição do ticket atual.
###################\
Outro detalhe é para quem nao tem um mac e usa a extensão para o codex, é um pouco diferente:
Na extensão do Codex no VS Code, o equivalente a “Custom instructions” não fica em uma caixinha na UI. O jeito oficial é por arquivos AGENTS.md (e/ou AGENTS.override.md) que o Codex lê antes de fazer qualquer coisa.
Como criar “custom instructions” (passo a passo)
- Instruções globais (valem para todos os projetos)
Vá para a sua pasta “home” do Codex (por padrão é ~/.codex; no seu print, é C:\Users\Ravi.codex).
Crie um destes arquivos (ordem de prioridade):
AGENTS.override.md (se existir, ele tem prioridade)
senão, AGENTS.md
Escreva suas regras ali.
Abraço ----
📧 Email: lenine@engrene.com.br
- 💬 WhatsApp: (67) 992612328
Créditos:
Ravi: github.com/rvidamasceno
#vibecoding #codex #openai #lenine #ravi

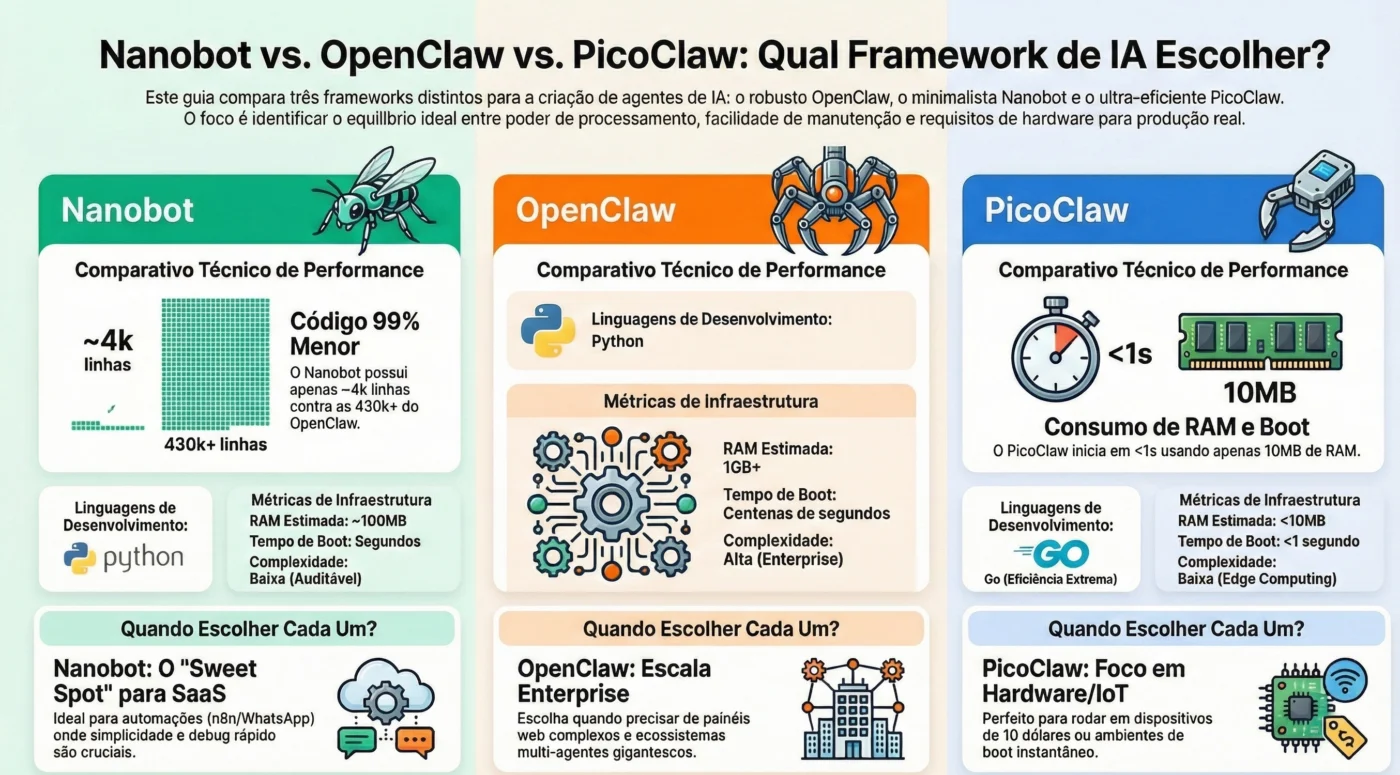
No mundo do desenvolvimento de agentes de IA, a escolha da ferramenta certa pode ser a diferença entre um projeto ágil e um pesadelo de manutenção. Embora o Nanobot, o OpenClaw e o PicoClaw compartilhem a mesma filosofia de "IA que faz coisas" (loop de agente, memória e skills), eles foram criados para propósitos e ambientes completamente diferentes.
Neste artigo, comparamos esses três pilares para que você saiba exatamente qual deles implementar em sua infraestrutura.
1. OpenClaw: O Peso-Pesado para Enterprise
O OpenClaw é um framework completo e robusto. Com mais de 430 mil linhas de código, ele é um "monolito" projetado para ser uma infraestrutura de delegação e automação para tudo.
- Destaques: Possui interface web (UI), gateway multi-canal (WhatsApp, Telegram, Discord, etc.) e roteamento avançado de modelos.
- Para quem é: Times que precisam de uma plataforma "all-in-one", multi-agente e com painéis de controle complexos.
- Custo: Exige mais hardware (geralmente acima de 1GB de RAM) e tem um processo de boot mais lento.
2. Nanobot: O Equilíbrio Ideal entre Simplicidade e Poder
O Nanobot é descrito como um "OpenClaw destilado". Ele reimplementa o espírito do original em Python, mas com apenas cerca de 3.500 a 4.000 linhas de código — ou seja, é 99% menor que o OpenClaw.
- Destaques: É leve, auditável e fácil de customizar. Roda com aproximadamente 100MB de RAM e integra-se perfeitamente com ecossistemas Python (como n8n e bibliotecas de IA).
- Para quem é: Desenvolvedores de automação e SaaS que buscam agilidade, baixo custo operacional e facilidade de debug sem abrir mão de memória persistente e tarefas agendadas.
3. PicoClaw: IA para o Limite da Eficiência (Edge Computing)
O PicoClaw leva o minimalismo ao extremo. Refatorado em linguagem Go a partir do Nanobot, seu foco é o hardware restrito.
- Destaques: Consegue rodar em menos de 10MB de RAM e em hardware de apenas 10 dólares (como RISC-V/ARM), realizando o boot em menos de um segundo.
- Para quem é: Casos de uso em IoT (Internet das Coisas), dispositivos de borda (edge) ou ambientes onde o custo de memória é o fator crítico.
Comparativo Técnico Rápido
Característica Nanobot OpenClaw PicoClaw Linguagem Python 3.10+ Principalmente Python Go RAM Típica ~100MB 1GB+ em produção <10MB Boot Segundos Centenas de segundos <1 segundo Complexidade Baixa Alta (múltiplos serviços) Baixa (binário único)Qual escolher para o seu projeto?
- Escolha o Nanobot se você quer colocar agentes em produção de forma sustentável, entende Python e precisa de flexibilidade para integrar com n8n ou CRMs em uma VPS comum. Ele costuma vencer em produção "normal" por ter menos peças móveis e menos pontos de falha.
- Escolha o OpenClaw se você precisa de uma estrutura pronta com interface visual, suporte multi-tenant avançado e tem uma equipe de SRE/MLOps dedicada para manter a stack pesada.
- Escolha o PicoClaw se o seu objetivo é rodar IA em uma "caixinha" de hardware barata ou em ambientes de cold start agressivo onde cada milissegundo e megabyte conta.
Conclusão
No fim das contas, a escolha "certa" não é sobre qual é o melhor, mas qual encaixa no seu modelo de risco e visão de longo prazo.
Para a maioria dos desenvolvedores que buscam agilidade e baixo overhead, o Nanobot surge como o ponto de equilíbrio perfeito.
Olá amigos do mundo automatik. Sempre nos deparamos com essa pergunta nos grupos do mundo automatik e as mensagens acabam se perdendo. Eu criei dois sistemas e não tinha me atendado para a falta de segurança, mas em um meeting desses da madrugada, o nosso amigo IMPA entrou no meu sistema que estava apresentando e mostrou algumas vulnerabilidades.
Embora o sistema não estivesse tão inseguro, ele encontrou chave exposta.
Com isso eu acabei, junto à comunidade, desenvolvendo técnicas de segurança no meu app dudabetic.com.br.
Com ajuda também do sistema de segurança do Fig, outro parceiro do mundo automatik, criei um sistema completo de segurança para meu software. Esse mesmo "prompt" foi usado por outros da comunidade e tendo muitos elogios.
Por esse motivo vou deixar disponibilizado aqui o texto para que vocês possam pedir pra suas IAs implementarem aí também.
Estou aberto a melhorias dele, entao se tiver alguma melhoria , ou até mesmo no meu sistema encontrar alguma vulnerabilidade de segurança ou até falhas, podem reportar por favor!
segue:
🛡️ Resumo Implementação Segurança - Aplicação Diabética
📋 Visão Geral
Implementamos uma suite completa de segurança para aplicação web de gestão diabética, seguindo padrões OWASP e melhores práticas de mercado.
🚀 O Que Fizemos
1. Análise de Vulnerabilidades
- ✅ Snyk CLI para scan de dependências
- ✅ ESLint Security com 15+ regras
- ✅ Detecção automática de secrets no código
2. Correções Críticas
- 🔒 *CORS: Removido wildcard "", implementado validação de origens
- 🚫 Rate Limiting: Middleware IP-based para Edge Functions
- 🛡️ Headers: X-Frame-Options, CSP, HSTS configurados
3. Proteção de Dados
- 🔐 Criptografia AES-256 client-side para dados sensíveis
- 📊 Dados protegidos: glicose, insulina, informações médicas
- 🔑 Chaves: Derivadas de user-specific + timestamp
4. Testes Automatizados
- 🕵️ Pentest: 300+ testes automatizados
- 🌀 Chaos Testing: Flood de requisições, fuzzing, stress test
- 📈 Load Testing: 500+ requisições simultâneas
- 🧠 Memory Leaks: Detecção de vazamentos
5. Monitoramento
- 📊 Dashboard Admin: /admin/security - métricas técnicas
- 👤 Dashboard Usuário: /security - status pessoal
- 🚨 Alertas: Tempo real para vulnerabilidades
- 📈 Métricas: Score de segurança 0-100
6. CI/CD Security
- 🔄 Pipeline GitHub Actions: Scan automático a cada push
- 📦 Dependencies: Verificação contínua com Snyk
- 🔍 Code Analysis: ESLint security em todo PR
- 🚫 Block Merge: Impede deploy com falhas críticas
🎯 Resultados
Antes vs Depois
Métrica Antes Depois Score Segurança 45/100 85/100 Vulnerabilidades Críticas 3 0 CORS Wildcard 5 funções 0 Rate Limiting 0 100% Monitoramento ❌ ✅Vulnerabilidades Resolvidas
- ❌ CORS Wildcard → ✅ Validação específica
- ❌ Sem Rate Limiting → ✅ IP-based throttling
- ❌ Dados não criptografados → ✅ AES-256 client-side
- ❌ Pacote xlsx vulnerável → ✅ Parser customizado
- ❌ Sem monitoramento → ✅ Dashboards em tempo real
🛠️ Tecnologias Utilizadas
Ferramentas
- Snyk: Scan de dependências
- ESLint Security: Análise estática
- CryptoJS: Criptografia AES-256
- Supabase: Edge Functions seguras
- GitHub Actions: CI/CD pipeline
Padrões
- OWASP Top 10: Todos cobertos
- CORS Strict: Validação de origens
- Rate Limiting: 100 req/min por IP
- Encryption: AES-256-GCM
- Monitoring: Tempo real
📋 Como Replicar
1. Setup Básico
bash
npm install -g snyk
snyk auth
npm run security:audit
2. Configuração
bash
ESLint Security
cp eslint.config.security.js ./
npm run lint:security
Criptografia
cp src/lib/crypto.ts ./
npm install crypto-js
3. Testes
bash
Pentest completo
npm run security:pentest
Chaos testing
npm run security:chaos
Dashboard
npm run dashboards:start
4. CI/CD
yaml
.github/workflows/security.yml
- name: Security Scan
run: npm run security:complete
🎯 Benefícios
Imediatos
- 🛡️ Zero vulnerabilidades críticas
- 📊 Monitoramento em tempo real
- 🔐 Dados sensíveis criptografados
- 🚨 Alertas automáticos
Longo Prazo
- 📈 Compliance LGPD/HIPAA
- 💰 Redução de custos com incidentes
- 🏆 Confiança do usuário
- 🔄 Melhoria contínua
🚀 Próximos Passos
Essenciais
- MFA: Autenticação multifator
- WAF: Web Application Firewall
- Backup Criptografado: Recuperação de desastres
- Pen Test Terceiro: Validação externa
Avançados
- Zero Trust: Arquitetura confiança zero
- Threat Modeling: Modelagem de ameaças
- Red Team: Testes de invasão
- Compliance: Certificações
📞 Contato Suporte
Para implementação nos seus sistemas:
- 📧 Email: lenine@engrene.com
- 💬 WhatsApp: (67) 992612328
- 🌐 Dashboard: https://engrene.com
Status: ✅ Produção | Score: 85/100 | Última Atualização: Dez/2025
Implementado seguindo padrões OWASP e melhores práticas de mercado


Guia prático para rodar TTS/STT grátis em ambiente OpenClaw + Docker Swarm.
1 - O que você vai ter no final
• TTS (texto → áudio): edge-tts (Microsoft Edge neural voices)
• STT (áudio → texto): faster-whisper (Whisper otimizado)
• API HTTP simples com endpoints:
• GET /health
• POST /tts
• POST /stt
• POST /stt-base64 (útil para webhooks)
• Voz PT-BR recomendada: pt-BR-ThalitaMultilingualNeural
2 - Pré-requisitos
• OpenClaw já rodando
• Docker Swarm ativo
• Rede overlay (ex: MINHA_REDE)
• (Opcional) Traefik para expor endpoint externo
• n8n/Evolution, se quiser automação WhatsApp
3 - Arquivo da API de voz
Crie main.py no servidor (ex.: /home/openclawbot/voice-tools/main.py) com FastAPI + edge-tts + faster-whisper.
Estrutura recomendada:
/home/openclawbot/voice-tools/main.py
4 - Subir o serviço no Swarm
Exemplo de criação de serviço:
sudo -n docker service create
--name voice_tools
--network MINHA_REDE
--replicas 1
--mount type=bind,src=/home/openclawbot/voice-tools/main.py,dst=/app/main.py,ro=true
python:3.11-slim
sh -lc "pip install --no-cache-dir fastapi uvicorn[standard] edge-tts faster-whisper python-multipart && uvicorn main:app --host 0.0.0.0 --port 8000 --app-dir /app"
5 - Testes básicos
Health
docker run --rm --network redesvp curlimages/curl:8.12.1 -sS http://voice_tools:8000/health
Resposta esperada:
{"ok":true}
TTS
docker run --rm --network redesvp curlimages/curl:8.12.1
-sS -X POST http://voice_tools:8000/tts
-F "text=Teste de voz em português do Brasil"
-F "voice=pt-BR-ThalitaMultilingualNeural" > teste.mp3
STT (arquivo)
docker run --rm --network redesvp
-v /tmp/audio.ogg:/tmp/audio.ogg
curlimages/curl:8.12.1 -sS -X POST http://voice_tools:8000/stt
-F "file=@/tmp/audio.ogg"
-F "language=pt"
-F "model_size=small"
6 - Voz brasileira recomendada
Para listar vozes PT-BR:
edge-tts --list-voices | grep pt-BR
Vozes comuns:
• pt-BR-FranciscaNeural
• pt-BR-AntonioNeural
• pt-BR-ThalitaMultilingualNeural ✅ (mais natural no teste)
7 - Integração no n8n (resumo)
• Para transcrição:
• HTTP Request → POST http://voice_tools:8000/stt (multipart file)
• ou POST /stt-base64 para payload em base64.
• Para resposta em voz:
• HTTP Request → POST http://voice_tools:8000/tts
• receber MP3 e enviar para canal (ex.: Evolution sendWhatsAppAudio).
8 - Dicas de qualidade
• Modelo STT:
• small = rápido/econômico
• medium = melhor qualidade (mais CPU)
• Use language=pt no STT para melhorar precisão
• No TTS, ajuste:
• voz (voice)
• ritmo/pausas no texto (pontuação bem feita)
9 -Troubleshooting rápido
• Could not connect to voice_tools:8000
• serviço ainda iniciando (pip install pode demorar)
• valide docker service ps voice_tools
• Sem transcrição
• formato de áudio inválido / sem áudio útil
• testar com /stt antes do /stt-base64
• Sotaque estranho
• trocar voz para pt-BR-ThalitaMultilingualNeural
10 - Segurança para produção
• Não deixar tokens/chaves hardcoded em workflow
• Guardar segredos em variáveis/secret fileS
• Não expor endpoint de voz sem autenticação se for público
• Monitorar logs e uso de CPU
Texto criado por Lila, assistente do Grupo SVP.
Pessoal deixo aqui para quem ta sem token ou consumindo muito, o site https://modal.com está com oferta incrivel de Glm5 ate 30/04 gratis:
1- Acesse o site https://modal.com/glm-5-endpoint
2- Faça Login.
3- Crie o token
Vai apareçer na tela o token criado e o curl
4- Copie ambos , e cole no seu chat da openclaw , ou use os endpoint conforme necessario.
5- No caso do Openclaw, informe junto , que quer que adicione essa LLM. Pronto, vai adicionar, pode usar como principal ou como Failback
Segue a dica, segue o Mundo Automátik e Bora pra cima pessoal.
Créditos :Renato Gomes