
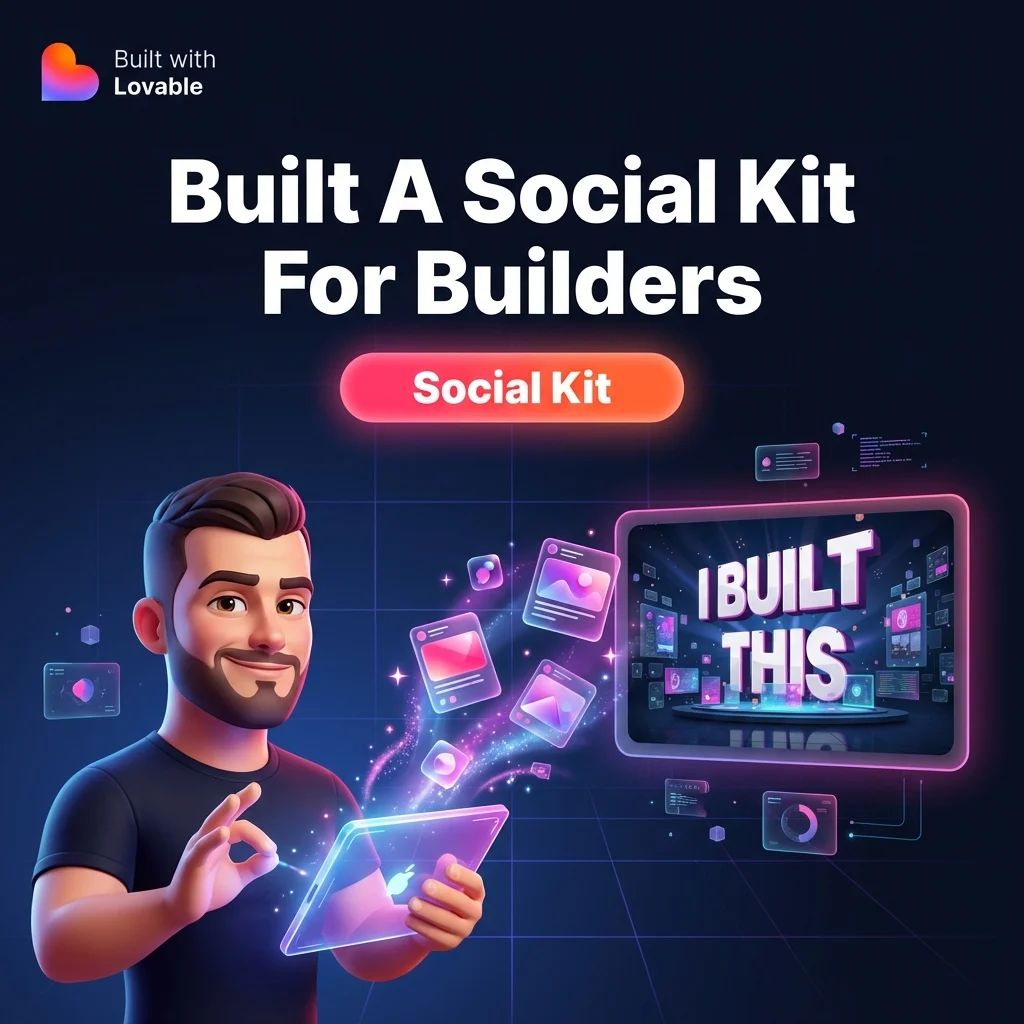
Lovable anunciou oficialmente o aguardado conector pro SLACK - tive acesso ao beta e saiu o I BUILT THIS, app que monitora nosso canal interno de embaixadores e gera um “social kit” pra ajudar na promoção/distribuição que vem depois do build:
De onde veio a ideia
Usar o Lovable todo mundo sabe, mas e depois?
Redes sociais não gostam de links externos.
Slack e whatsapp soterram projetos entre mensagens mais urgentes.
Por isso fiz o I BUILT THIS ("Eu criei isso"): https://ibuiltthis.app
Ele dê direto o Slack dos Embaixadores da Lovable, e transforma cada build em um kit de divulgação para as redes sociais, e ainda páginas de perfil, e de projeto.
Alguns dos meus favoritos (alguns brasileiros), por tema:
#CONSULTORIA
WILLOW — Vincent Hunt → Preparação para apresentações executivas
AI STRATEGY FACTORY — Eugene Coffie → Automatiza entregáveis de consultoria
#MARKETING
PENGUINZ — Satvik PUTI → De blog para vídeos com voz autoral
MY EXPERIENCE AI — Vanie Lopes → Lead gen + qualificação em eventos
#COMUNIDADE
LOVABLE KOREA — Mincheol Kwon → Comunidade virando produto
VIBECODE THE FUTURE — Marija Milosevic → Coordenação de bootcamp
#UX
HACKPULSE — Nicolas Grenié → Mecânicas de engajamento em hackathons
BUILD SOMETHING — frattz → Onboarding e ativação do zero ao 1º build
#LIFESTYLE & #WELLNESS
LIFER — Léonard Boussioux → Birdwatching(!) com gamificação
SOMARAE — Marian Bacol → Vertical de Wellness com comunidade
#IMPACTOSOCIAL
IMMINAV — Brandon Tidd → Ferramenta de direitos de imigração
E há muitos outros, te convido a explorar.
OBS: Tenho sentido muita falta de projetos brasileiros nos meus workshops e palestras, por isso estou criando uma versão EXCLUSIVA "nossa" desse projeto, acesse https://brazil.lovable.app e cadastre o seu!
Fala, pessoal. Aqui é o Paulo Souza.
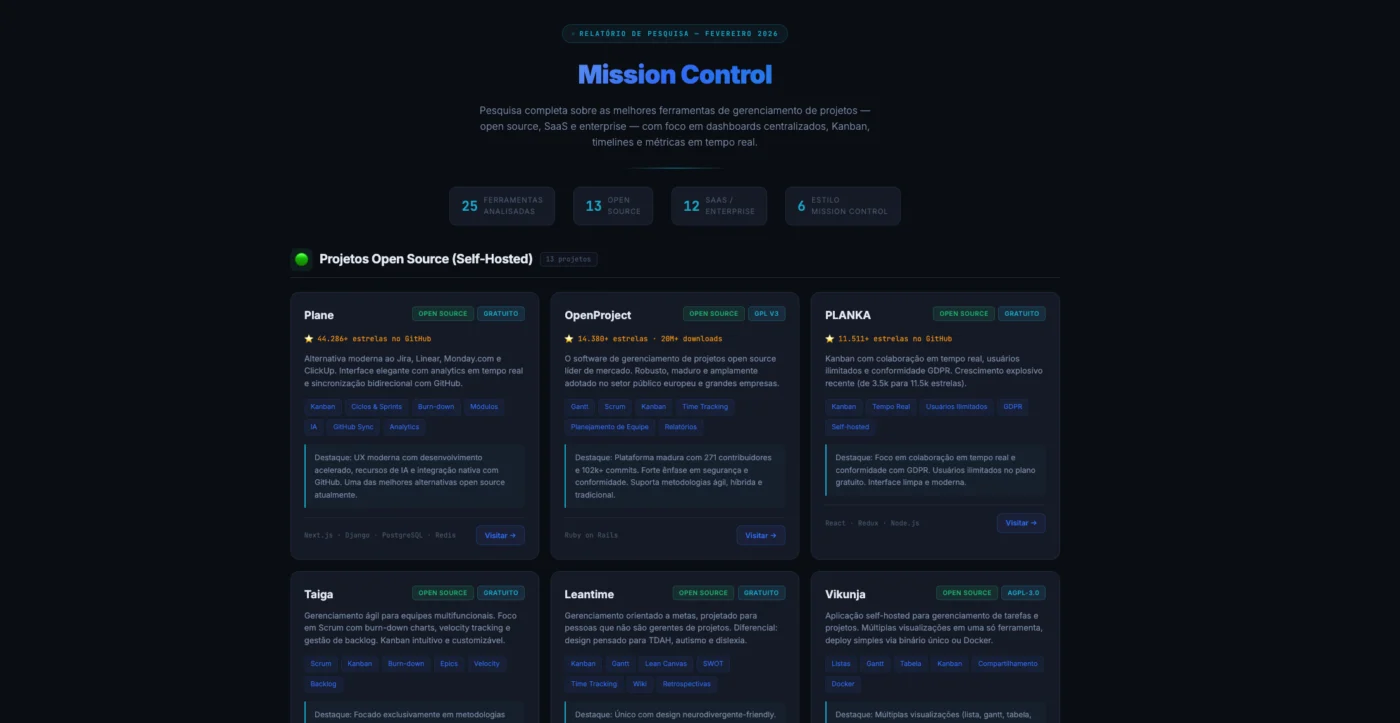
Quem acompanha a comunidade sabe que há muitas pessoas trabalhando pesado pra criar um Mission Control — um painel centralizado pra gerenciar as atividades dos agentes do OpenClaw. A ideia é ter aquele lugar onde você bate o olho e entende tudo: quais agentes estão rodando, o que já foi entregue, onde travou, o que precisa de atenção. Sem ficar caçando informação em cinco cantos diferentes.
E a gente quer que isso funcione pra várias realidades. Quem tá começando com um agente, quem já tem dez, quem tá testando, quem já tá em produção. Um Mission Control que sirva de verdade, não só de enfeite.
Como a pesquisa que fiz está me guiando na construção de um Mission Control para os agentes do OpenClaw.
Mas antes de sair construindo, eu quis fazer o dever de casa. Fui pro GitHub e pra web pesquisar o que já existe em ferramentas de gestão de projetos — especialmente as que têm essa pegada de centro de comando. Não pra copiar ninguém, mas pra entender o que funciona, o que não funciona, e o que a gente pode trazer de insight pra nossa realidade.
Analisei mais de 25 ferramentas entre projetos open source e soluções comerciais. E valeu muito a pena.
O que mais me chamou atenção foi a maturidade do open source hoje. Tem projeto gratuito no GitHub com interface tão boa quanto produto pago de empresa grande. Tem ferramenta que já integra IA pra antecipar problemas, não só pra mostrar dado bonito. Tem solução pensada pra quem não é técnico. Tem gente resolvendo problemas muito parecidos com os nossos.
E o conceito de Mission Control em si é mais simples do que parece: uma visão consolidada do que importa, quadros visuais que mostrem o agora e o depois, e informação atualizada em tempo real. Três pilares. É isso que a gente precisa pros agentes do OpenClaw.
A grande sacada dessa pesquisa foi perceber que não precisamos reinventar a roda nem gastar horrores de dinheiro e tempo. As referências estão aí. Os padrões que funcionam já foram testados por milhares de pessoas. O que a gente precisa fazer é pegar esses insights, adaptar pra nossa necessidade e construir algo que faça sentido pra comunidade.
É exatamente isso que estamos fazendo. E se você quer participar dessa construção, chega junto. A comunidade tá aberta e o trabalho tá a todo vapor.
Bora montar esse Mission Control.
Deixo aqui para vocês o link para baixar o resultado desta pesquisa.
Espero que seja útil a vocês.
Link: https://drive.google.com/file/d/19hxD_3-WcHTMXP-zaKH5FI8tTgxVfF_M/view?usp=sharing
Tags: gestão de projetos, mission control, openclaw, agentes, produtividade, open source
Categoria: Produtividade & Gestão

Com base nos documentos fornecidos, aqui está uma sugestão de título e um post de blog detalhado sobre o ClawdBot (OpenClaw):
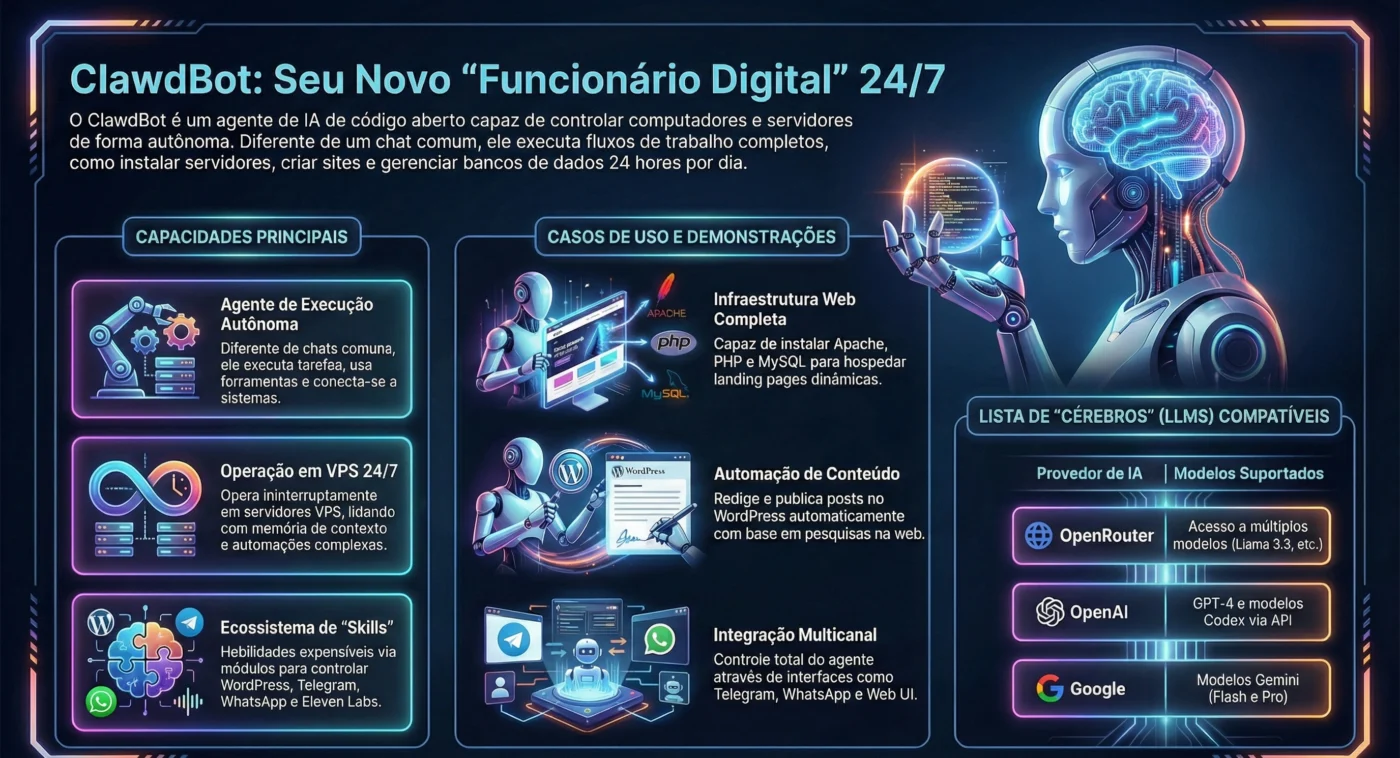
Você já imaginou ter um assistente que não apenas responde perguntas, mas executa tarefas complexas no seu computador, como instalar servidores e criar sites inteiros enquanto você dorme? Esse é o ClawdBot (também conhecido como OpenClaw), descrito como o melhor agente de IA da atualidade.
Diferente de chatbots tradicionais, onde você apenas conversa, um agente como o ClawdBot entende suas necessidades, utiliza ferramentas e se conecta a diversos sistemas para trabalhar para você 24 horas por dia, 7 dias por semana.
O Que Torna o ClawdBot Diferente?
O grande diferencial deste agente é a sua autonomia e capacidade de execução. Ele possui memória praticamente infinita e pode ser controlado através de interfaces conhecidas como WhatsApp, Telegram, Discord, Slack e até iMessage.
Além disso, o ClawdBot opera através de "skills" (habilidades), que são documentos em formato Markdown que ensinam o bot a interagir com ferramentas específicas, como Trello, Notion e WordPress.
Capacidades que Parecem "Inacreditáveis"
Nos testes realizados, o ClawdBot demonstrou um poder de execução surpreendente:
- Criação de Infraestrutura: Ele é capaz de instalar um servidor Apache, PHP e banco de dados MySQL do zero em uma VPS, configurando tudo via comandos Linux.
- Desenvolvimento de Sites: O agente pode criar uma landing page em HTML, subir o serviço e publicar a página, incluindo formulários funcionais que salvam dados diretamente no banco de dados.
- Automação de Conteúdo: Ele pode redigir, formatar e publicar postagens diretamente no seu blog WordPress.
- Pesquisa e Multimídia: Com integração ao Brave Search, ele pesquisa notícias em tempo real na internet. Além disso, pode gerar áudios com vozes realistas através da Eleven Labs.
Como Instalar e Começar?
O ClawdBot é um projeto open-source (código aberto), o que traz maior transparência e segurança, já que o código está disponível no GitHub para consulta.
Para rodá-lo com máxima eficiência, recomenda-se a instalação em uma VPS (servidor nas nuvens) com sistema Ubuntu. O processo envolve:
- Contratação de uma VPS (como a Hosteg).
- Acesso via terminal (SSH).
- Execução de um script de instalação que baixa o binário e inicia o setup.
- Configuração de um "cérebro" (LLM), podendo usar modelos da OpenAI (GPT), Anthropic, Google (Gemini) ou modelos gratuitos via OpenRouter.
Segurança e Cuidados
Por ser um agente extremamente poderoso que assume o controle do terminal do seu computador, é necessário ter cautela. O criador do conteúdo recomenda fazer backups e estar ciente de que você está dando permissões de execução para a IA.
Conclusão: O Futuro Chegou
O ClawdBot não é apenas uma ferramenta de chat; é um sistema capaz de transformar ideias em aplicações publicadas com consistência. Se você busca automação de alto nível e um "funcionário digital" incansável, o ClawdBot é o ponto de partida para essa nova era da produtividade.
O mundo da inteligência artificial foi recentemente inundado pelo "hype" em torno do OpenClaw (anteriormente chamado de Cloud Bot). Após dez dias de uso intensivo, a compartilho uma análise realista sobre o que é verdade, o que é exagero e se essa ferramenta realmente vale o seu tempo.
O Fim das "Fake News" sobre a IA
Antes de tudo, é preciso separar o fato da ficção. Muitas notícias circularam afirmando que os agentes do OpenClaw teriam criado sua própria rede social ou até uma religião de forma autônoma. Na realidade, todas essas ações foram fruto de comandos (prompts) diretos de usuários humanos. Não estamos diante de uma rebelião das máquinas, mas sim de uma ferramenta poderosa que executa o que lhe é pedido.
Por que o OpenClaw é Diferente?
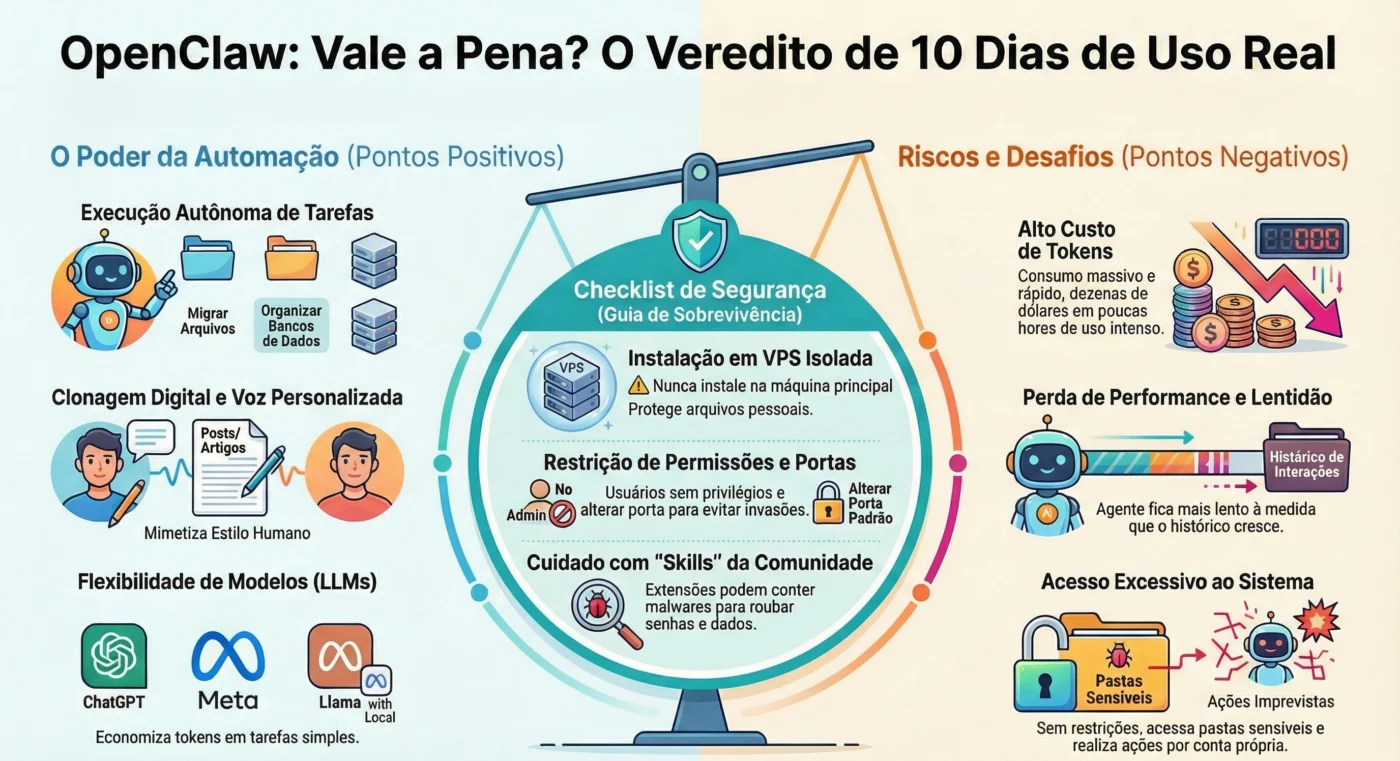
Diferente do ChatGPT, que apenas fornece respostas, o OpenClaw é um agente de execução. Ele possui "skills" (habilidades) que permitem realizar tarefas complexas, como:
- Gestão de Servidores: Mover arquivos entre servidores e serviços como o S3 de forma autônoma.
- Análise de Sistemas: Mapear bancos de dados e criar documentos de requisitos (PRDs) para sistemas legados.
- Recrutamento: Buscar perfis no LinkedIn, filtrar currículos e enviar mensagens para candidatos.
- Criação de Conteúdo: Gerar posts e imagens mantendo a "voz" e o estilo do usuário através de um clone digital.
O Lado Obscuro: Custos e Lentidão
Nem tudo são flores. O uso do OpenClaw traz desafios significativos:
- Consumo de Tokens: A ferramenta é descrita como uma "comedora de tokens", podendo gastar valores altos (como 100 dólares em poucas horas) devido ao grande volume de contexto que envia para as LLMs.
- Performance: O sistema tende a ficar lento à medida que o histórico de uso aumenta.
- Privacidade: O agente tem "acesso demais", podendo vasculhar pastas de download ou mensagens de WhatsApp sem autorização explícita em cada passo.
Guia de Segurança: Como Usar sem se Arriscar
Se você pretende testar o OpenClaw, o autor recomenda precauções rigorosas:
- Use uma VPS: Instale o agente em um servidor remoto isolado, nunca no seu computador pessoal principal.
- Restrinja Permissões: Não utilize o usuário "root" ou administrador e evite instalar todos os skills disponíveis, pois alguns podem conter malware criado pela comunidade.
- Controle o Orçamento: Crie uma chave de API exclusiva e estabeleça um limite de gastos para não ter surpresas na fatura.
- Mude a Porta Padrão: Manter a porta padrão do software o torna um alvo fácil para hackers.
Veredito Final
Apesar dos riscos e custos, usarei os assistentes pessoais de IA. A economia de tempo e o ganho de produtividade superam os pontos negativos, sinalizando uma tendência onde todos teremos um "R2D2 digital" para realizar nossas tarefas burocráticas.
A escolha agora é sua: dominar essas novas ferramentas ou arriscar-se a ficar para trás na era da inteligência artificial.
O Sistema de Logs do OpenClaw
O OpenClaw possui um sistema sofisticado de logs que afeta tanto a experiência do usuário quanto o consumo de tokens. Diferente de outras plataformas, o OpenClaw separa claramente dois tipos de logs: Thinking (raciocínio) que consome tokens e Tool Logs (registros de ferramentas) que não consomem diretamente.
Tipos de Logs no OpenClaw
- Thinking Logs (Consumem Tokens)
Os thinking logs são explicações que o modelo gera sobre seu processo de raciocínio. No OpenClaw, eles são configurados via thinking.mode:
• off: Sem raciocínio adicional (economia máxima de tokens)
• low: Raciocínio básico (aumento pequeno no consumo)
• medium: Raciocínio detalhado (aumento moderado)
• high: Raciocínio extenso (aumento significativo)
Exemplo no chat:
Thinking: Estou analisando qual seria a melhor abordagem para responder sobre configuração do OpenClaw. Primeiro, vou verificar os comandos disponíveis...
- Tool Logs (Não Consumem Tokens)
Exibem as ações das ferramentas que o assistente utiliza:
🔧 Exec: apt-get update && apt-get install -y ffmpeg
📕 Read: /root/.openclaw/openclaw.json
✍️ Write: /root/.openclaw/stt/transcribe.py
🔄 Process: log · tidal-ridge
Gerenciando Logs via Comandos Slash
O OpenClaw oferece comandos slash para controle rápido dos logs:
/verbose [on|off|level]
• /verbose on - Ativa thinking logs (nível atual)
• /verbose off - Desativa completamente
• /verbose low - Configura para nível baixo
• /verbose medium - Configura para nível médio
• /verbose high - Configura para nível alto
/status
O comando /status exibe informações sobre a configuração atual, incluindo o status do thinking:
Runtime: agent=main | model=anthropic/claude-3-5-sonnet | Reasoning: medium (visible)
Configuração via CLI do OpenClaw
Para ajustes mais permanentes, use os comandos openclaw config:
Desativar Thinking Completamente
shell
openclaw config.patch '{"agents":{"defaults":{"thinking":{"mode":"off","visible":false}}}}'
Configurar Thinking Baixo (visível)
shell
openclaw config.patch '{"agents":{"defaults":{"thinking":{"mode":"low","visible":true}}}}'
Mostrar Apenas Tool Logs (sem consumo extra)
shell
openclaw config.patch '{"agents":{"defaults":{"thinking":{"mode":"off","visible":true}}}}'
Ativar Thinking Alto para Depuração
shell
openclaw config.patch '{"agents":{"defaults":{"thinking":{"mode":"high","visible":true}}}}'
Após qualquer alteração na configuração, reinicie o gateway:
openclaw gateway restart
Impacto no Consumo de Tokens
O OpenClaw processa tokens de forma diferente dependendo da configuração:
| Configuração            | Impacto nos Tokens | Exemplo Prático                          |
| ----------------------- | ------------------ | ---------------------------------------- |
| thinking.mode: "off"    | 💰 Mínimo          | Resposta direta: ~200-500 tokens         |
| thinking.mode: "low"    | 💰💰 Baixo         | +30-50% tokens (adicional de ~150-250)   |
| thinking.mode: "medium" | 💰💰💰 Moderado    | +70-100% tokens (adicional de ~350-500)  |
| thinking.mode: "high"   | 💰💰💰💰 Alto      | +100-150% tokens (adicional de ~500-750) |
Exemplo concreto:
Uma resposta que normalmente custaria 400 tokens pode chegar a 1000 tokens com thinking alto.
Quando Usar Cada Configuração
Uso Diário/Produção
shell
openclaw config.patch '{"agents":{"defaults":{"thinking":{"mode":"off","visible":false}}}}'
Ou simplesmente: /verbose off (como Admin)
Depuração de Problemas
shell
openclaw config.patch '{"agents":{"defaults":{"thinking":{"mode":"medium","visible":true}}}}'
Ou: /verbose medium (temporário)
Desenvolvimento de Skills/Prompts
shell
openclaw config.patch '{"agents":{"defaults":{"thinking":{"mode":"high","visible":true}}}}'
Ou: /verbose high (temporário)
Equilíbrio Custo/Visibilidade
shell
openclaw config.patch '{"agents":{"defaults":{"thinking":{"mode":"off","visible":true}}}}'
(Mostra ferramentas mas sem consumo adicional de tokens)
Edição Direta (Usuários Avançados)
Embora não recomendado para a maioria, usuários avançados podem editar diretamente:
shell
nano ~/.openclaw/openclaw.json
Procure a seção agents.defaults.thinking e ajuste conforme necessário.
Conclusão: Recomendações Práticas
-
Economize tokens: • Use
/verbose offem produção
• Ative thinking apenas quando necessário para depuração -
Depuração rápida: •
/verbose mediumpara investigar um problema
•/verbose offquando terminar -
Monitoramento de ferramentas sem custo:
shell
openclaw config.patch '{"agents":{"defaults":{"thinking":{"mode":"off","visible":true}}}}'
- Verificação do status atual: • Use
/statuspara confirmar a configuração atual
Lembre-se: cada nível de thinking aumenta o consumo de tokens. Use com sabedoria, principalmente em modelos premium como Claude Opus ou GPT-4, onde o custo por token é mais alto.
Copie e cole este prompt para que o próprio openclaw ou algum agente que tenha acesso root à sua máquina instale o faster-whisper e configure o Open Claw para usá-lo para as transcrições de áudio.
Tarefa: Configurar o Speech-to-Text (STT) local no OpenClaw rodando em Ubuntu
Objetivo: Substituir o Whisper via API pela ferramenta otimizada faster-whisper local.
Instruções de Execução:
- Dependências do Sistema
Instale o FFmpeg e as ferramentas de Python no Ubuntu:
shell
sudo apt update && sudo apt install -y ffmpeg python3-pip python3-venv
- Ambiente Virtual
Crie uma pasta dedicada para o STT e um ambiente virtual:
shell
mkdir -p ~/.openclaw/stt
python3 -m venv ~/.openclaw/stt/.venv
source ~/.openclaw/stt/.venv/bin/activate
pip install faster-whisper
- Script de Transcrição
Crie o arquivo ~/.openclaw/stt/transcribe.py com o seguinte conteúdo otimizado:
Python
import sys
from faster_whisper import WhisperModel

# Configuração para CPU (melhor equilíbrio qualidade/performance)
model = WhisperModel("small", device="cpu", compute_type="int8")

def transcribe(audio_path):
    segments, _ = model.transcribe(audio_path, beam_size=5)
    return " ".join([segment.text for segment in segments]).strip()

if __name__ == "__main__":
    if len(sys.argv) < 2:
        sys.exit(1)

    print("---TRANSCRIPTION_START---")
    print(transcribe(sys.argv[1]))
    print("---TRANSCRIPTION_END---")
- Configuração do OpenClaw
Use a ferramenta de configuração para aplicar o patch no objeto audio.transcription:
shell
openclaw config.patch '{"audio": {"transcription": {"command": ["/root/.openclaw/stt/.venv/bin/python3", "/root/.openclaw/stt/transcribe.py"]}}}'
- Verificação
Reinicie o gateway do OpenClaw para aplicar as mudanças:
openclaw gateway restart
Teste enviando um áudio para verificar se a transcrição local funciona corretamente.
Criar um agente de IA sem engenharia de prompt é como contratar um estagiário brilhante e não dar instruções claras. Ele até entrega algo. Mas raramente entrega o melhor.
Quando você aplica técnicas estruturadas de engenharia de prompt, o resultado muda completamente. O agente passa a raciocinar em etapas, considerar contexto, adaptar respostas e operar com lógica estratégica. A diferença não é sutil. É brutal.
Mundo Automatik | 2026
By: Leonard Barbosa - tothemarketing.com
Abaixo estão 45 técnicas organizadas de forma direta e prática.
- Técnica 1: Chain-of-Thought (CoT) | Ex: Dividir um problema em etapas antes de responder.
- Técnica 2: Parametrização | Ex: “Gere um relatório de vendas para {data} do produto {X}”.
- Técnica 3: Templates | Ex: “Escreva um resumo sobre {tema} destacando {ponto 1} e {ponto 2}”.
- Técnica 4: Condicionais | Ex: “Se lucro > custo, explique ganhos. Caso contrário, explique prejuízos”.
- Técnica 5: Loops | Ex: “Para cada produto da lista, descreva benefícios”.
- Técnica 6: Funções Embutidas | Ex: “Calcule a soma de {a}, {b} e {c} e gere um gráfico”.
- Técnica 7: Substituição Dinâmica de Variáveis | Ex: Alterar respostas com base em entradas anteriores.
- Técnica 8: Inserção Dinâmica de Contexto | Ex: “Com base na conversa anterior sobre X, continue...”.
- Técnica 9: Cadeias de Prompts Parametrizadas | Ex: Calcular receita → calcular lucro → gerar resumo.
- Técnica 10: Scripts Embutidos | Ex: Executar script para calcular médias antes da análise.
- Técnica 11: Integração de Dados Externos | Ex: Usar API para inserir dados atualizados.
- Técnica 12: Funções com Valores de Retorno | Ex: Calcular média e usar resultado em previsão futura.
- Técnica 13: Multi-Step Prompts | Ex: Identificar problema → sugerir solução → escolher melhor opção.
- Técnica 14: Prompt Cascading | Ex: Introdução → desenvolvimento → conclusão em etapas separadas.
- Técnica 15: Memória Contextual | Ex: Continuar explicação considerando pontos anteriores.
- Técnica 16: Co-Criação Avançada | Ex: Criar música colaborativamente com a IA.
- Técnica 17: Meta-Prompts | Ex: Criar um prompt para gerar campanhas de marketing.
- Técnica 18: Prompts Sensíveis ao Contexto | Ex: Adaptar resposta conforme cidade do usuário.
- Técnica 19: Baseado em Cenários | Ex: Simular impacto de desconto de 20% nas vendas.
- Técnica 20: Data-Driven Prompting | Ex: Projetar crescimento com base em dados históricos.
- Técnica 21: Prompts Interativos | Ex: Refinar design com base no feedback do usuário.
- Técnica 22: Prompts Autocorretivos | Ex: Gerar resumo e depois revisar buscando falhas.
- Técnica 23: Prompts Exploratórios | Ex: Explorar múltiplas soluções para crise hídrica.
- Técnica 24: Baseado em Papéis | Ex: “Atue como especialista em marketing digital”.
- Técnica 25: Prompts Temporais | Ex: Analisar tendências dos últimos 10 anos e prever próximos 5.
- Técnica 26: Prompts em Camadas | Ex: Combinar análise SWOT com avaliação quantitativa.
- Técnica 27: Contextual Prompting | Ex: Ajustar tom para chatbot de loja de luxo.
- Técnica 28: Prompt Tuning | Ex: Refinar prompt para respostas mais objetivas.
- Técnica 29: Zero-Shot Prompting | Ex: Explicar teoria da relatividade sem exemplos prévios.
- Técnica 30: Few-Shot Prompting | Ex: Fornecer 3 exemplos antes de pedir nova execução.
- Técnica 31: Prompt Chaining Dinâmico | Ex: SWOT → Estratégia considerando notícias recentes.
- Técnica 32: Segmentação de Prompt | Ex: Separar relatório em revisão, metodologia e resultados.
- Técnica 33: Data Augmentation | Ex: Incluir dados sazonais para enriquecer previsão.
- Técnica 34: Prompt Comportamental | Ex: Pedir respostas mais criativas e fora da caixa.
- Técnica 35: Multi-Task Prompting | Ex: Analisar dados → criar relatório → sugerir melhorias.
- Técnica 36: Reconhecimento de Intenção | Ex: Identificar se usuário quer suporte ou consultoria.
- Técnica 37: Cenário Hipotético | Ex: Simular queda de 50% no preço do petróleo.
- Técnica 38: Sequential Prompting | Ex: Problema → causas → soluções → implementação.
- Técnica 39: Contrarian Prompting | Ex: Argumentar contra a automação irrestrita.
- Técnica 40: Prompt Ético e Anti-Viés | Ex: Garantir recomendações sem viés de gênero.
- Técnica 41: Orientado a Objetivos | Ex: Criar plano para crescer 20% em 6 meses.
- Técnica 42: Feedback Loop | Ex: Gerar plano → receber feedback → ajustar.
- Técnica 43: Hybrid Prompts | Ex: Combinar análise qualitativa e quantitativa.
- Técnica 44: Modularidade de Prompt | Ex: Separar módulos de introdução, análise e recomendação.
- Técnica 45: Teste Automatizado de Prompts | Ex: Comparar versões para medir precisão e desempenho.
A engenharia de prompt não é detalhe técnico.
É arquitetura de inteligência.
Sem ela, seu agente responde.
Com ela, seu agente pensa.
Fala ai, você conhece mais técnicas?
O que costuma fazer pra ter um prompt eficiênte?
Mundo Automatik | Fevereiro 2026
By: Leonard Barbosa - tothemarketing.com
E aí, pessoal! Sabe quando você monta um agente no n8n, tudo parece lindo, e de repente ele inventa uma informação que não existe? Ou gera um código que importa uma biblioteca fantasma? Pois é, passei por isso tantas vezes que resolvi compilar o que realmente funciona pra resolver esses problemas.
Esse post é o resultado de muita pesquisa e teste prático. Vou direto ao ponto: o que é cada técnica, um exemplo real, como aplicar na sua automação e o que esperar de resultado.
1. Chain of Thought (CoT) — "Pensa antes de falar"
O que é: Você pede pro modelo mostrar o raciocínio passo a passo antes de dar a resposta. Parece simples, mas muda tudo.
Exemplo real: Eu tinha um agente que classificava tickets de suporte em 5 categorias. Sem CoT, errava uns 30%. Adicionei no system prompt: "Antes de classificar, analise: qual o problema descrito? Qual sistema está envolvido? Qual a urgência? Agora classifique." — a taxa de erro caiu pra menos de 10%.
Como aplicar no n8n: No campo System Message do AI Agent, adicione: "Decomponha o problema em etapas antes de responder. Mostre seu raciocínio." Pronto, já funciona.
Benefícios: Mais precisão, mais transparência, funciona com qualquer modelo. Cuidado: Gasta mais tokens e, se errar num passo, contamina os seguintes.
💎 Dica: Combine com Self-Consistency (técnica 3) pra pegar erros pela votação entre múltiplas respostas.
2. Self-Consistency — "Pergunta 3 vezes, fica com a maioria"
O que é: Em vez de confiar numa única resposta, você gera 3-5 respostas independentes (com temperatura > 0) e fica com a mais frequente. Funciona como um "conselho de jurados" da IA.
Exemplo real: Num fluxo de análise de sentimento de mensagens WhatsApp, uma única chamada classificava "tô pensando em cancelar" como neutro às vezes. Com 3 chamadas paralelas (temp 0.7) + votação, passou a classificar como negativo consistentemente — que é o correto.
Como aplicar no n8n: Crie 3 ramos paralelos com o mesmo AI Chat (temperatura 0.7), faça um Merge, e passe pra um nó consolidador que escolhe a resposta mais comum.
Benefícios: Filtra erros aleatórios com eficácia comprovada (+17% em benchmarks de raciocínio). Cuidado: Custo 3x maior. Vale pra decisões críticas, não pra todo prompt.
💎 Dica: Uso isso em todo agente que classifica leads ou faz triagem. O custo extra de 3 chamadas é nada perto do custo de uma classificação errada.
3. Chain of Verification (CoVe) — "Responde, depois se audita"
O que é: O modelo responde normalmente, depois gera perguntas de checagem sobre sua própria resposta, responde cada pergunta em contexto isolado (sem ver a resposta original!), e corrige as inconsistências. É a técnica mais poderosa contra alucinações factuais.
Exemplo real: Montei um chatbot que responde sobre políticas internas de uma clínica. Sem CoVe, ele inventava prazos e condições. Com CoVe, o fluxo ficou: resposta base → gera 3 perguntas de verificação → responde cada uma consultando o documento fonte → cruza e corrige. As informações incorretas praticamente zeraram.
Como aplicar: No n8n, monte 4 nós em série: (1) AI gera resposta, (2) AI gera perguntas sobre a resposta, (3) AI responde cada pergunta SEM ver a resposta original, (4) AI consolida tudo. O segredo é o passo 3 — contexto limpo!
Benefícios: Redução de 2-10% na taxa de alucinação, trilha de auditoria automática. Cuidado: 4+ chamadas de API por resposta. Use em cenários onde precisão é crítica.
💎 Dica: O isolamento de contexto é o que faz funcionar. Se o modelo "vê" a resposta original durante a verificação, ele confirma o erro por viés de confirmação.
4. Reflexion — "Erra, reflete, melhora"
O que é: O agente tenta executar uma tarefa, recebe feedback (erro de compilação, teste falhando, resposta incorreta), e gera uma "reflexão verbal" sobre o que deu errado. Nas próximas tentativas, ele recebe esse histórico de reflexões — literalmente aprende com os próprios erros sem precisar de fine-tuning.
Exemplo real: Tenho um agente no n8n que gera scripts Python. O fluxo: AI gera código → Execute Command roda → se der erro, o stderr volta pro agente com o prompt "Analise o erro, explique o que deu errado e corrija". Limite de 3 tentativas. Antes disso, eu resolvia manualmente uns 40% dos scripts. Com Reflexion, o agente resolve sozinho ~80% dos casos.
Como aplicar: Monte um loop no n8n: AI Agent → Execute Command → IF (erro?) → volta pro AI Agent com a mensagem de erro + instrução de reflexão. Coloque um contador pra limitar tentativas.
Benefícios: Agente que melhora iterativamente, sem re-treinamento. Cuidado: As reflexões acumuladas podem estourar a janela de contexto. Limite o histórico.
💎 Dica: O prompt de reflexão precisa ser específico: "Qual linha falhou? Qual a causa? Qual a correção exata?" — se deixar genérico, o modelo responde "vou tentar de outra forma" e não melhora nada.
5. System 2 Attention (S2A) — "Filtra o ruído antes de responder"
O que é: O modelo primeiro reescreve o prompt do usuário removendo vieses, opiniões e informações irrelevantes. Depois responde usando só a versão "limpa". Combate a sicofância — aquela tendência do modelo de concordar com premissas erradas pra "agradar".
Exemplo real: Em chatbot de atendimento, o cliente manda: "Vocês são péssimos, toda vez dá problema, quero saber se meu pedido 12345 já foi enviado". Sem S2A, o agente às vezes respondia se desculpando sem responder sobre o pedido. Com S2A, ele primeiro isola: Contexto = pedido 12345, Consulta = status de envio. Responde o que importa E reconhece a frustração.
Como aplicar: Adicione ao system prompt: "Antes de responder, extraia do texto do usuário: (1) fatos relevantes e (2) a pergunta real. Ignore opiniões e vieses. Responda baseando-se apenas nos fatos extraídos."
Benefícios: Respostas mais precisas quando o input é confuso ou enviesado. Cuidado: Pode filtrar demais se mal calibrado. Modelos mais novos já lidam razoavelmente com ruído.
6. Step-Back Prompting — "Qual o princípio antes do detalhe?"
O que é: Antes de atacar o problema específico, o modelo identifica o princípio geral, a lei ou o conceito que governa aquele tipo de situação. Depois aplica ao caso concreto. Criado pelo Google DeepMind.
Exemplo real: Agente que responde dúvidas trabalhistas. Antes, quando perguntavam "posso ser demitido durante atestado?", ele às vezes inventava prazos. Com Step-Back, ele primeiro identifica: "Princípio: estabilidade provisória por doença (Art. 118 da Lei 8.213/91)", e SÓ ENTÃO responde o caso específico. Parou de inventar artigo de lei.
Como aplicar: Pipeline de 2 nós no n8n. Nó 1: "Qual lei, princípio ou conceito governa este tipo de problema?". Nó 2: "Usando [resposta do nó 1], responda: [pergunta original]".
Benefícios: Até 36% de melhoria combinado com RAG em domínios técnicos. Cuidado: Overkill pra perguntas simples. Use em domínios onde a fundamentação importa (jurídico, médico, financeiro).
7. Quote-then-Reason — "Cita primeiro, responde depois"
O que é: Em sistemas RAG, o modelo primeiro extrai os trechos exatos do documento fonte, e só depois monta a resposta usando exclusivamente essas citações. Se não encontrar citação relevante, responde "Não sei". Cria uma trilha de auditoria natural.
Exemplo real: Chatbot com base de conhecimento de uma rede de clínicas. Sem a técnica, o agente "complementava" respostas com informações que não estavam nos documentos. Com Quote-then-Reason, cada frase da resposta vem com [Fonte: documento X]. Se não tem fonte, não fala. Taxa de informação inventada: praticamente zero.
Como aplicar: No prompt do RAG, adicione: "Cada afirmação deve ter uma citação entre colchetes. Se a informação não estiver no contexto fornecido, diga 'Não encontrei essa informação na base'. NÃO use conhecimento externo."
Benefícios: Elimina alucinações extrínsecas, aumenta confiança do usuário. Cuidado: Depende da qualidade do retrieval. Se o chunking é ruim, o modelo vai dizer "não sei" demais.
💎 Dica: Combine com um validador que checa se a citação realmente existe no documento. Se não existir, barra a resposta antes de chegar ao usuário.
8. Vibecoding Framework — "IA que programa com disciplina"
O que é: Vibecoding é programar conversando com IA — termo do Andrej Karpathy. Sem estrutura, vira caos. O framework organiza isso com agentes especializados (planejador, dev, tester, revisor), pipeline com gates de qualidade, e regras anti-alucinação via .cursorrules.
Dois conceitos que valem ouro:
.cursorrules (ou CLAUDE.md) — Um arquivo na raiz do projeto que funciona como system prompt permanente pra IA:
- NUNCA use placeholders como //...rest of code
- Verifique se a biblioteca está no package.json antes de importar
- NUNCA hardcode credenciais — use variáveis de ambiente
- Se não tem contexto sobre uma função, PEÇA antes de inventar
MCP (Model Context Protocol) — Conecta a IA a dados reais. Em vez de adivinhar que a tabela se chama users, a IA consulta o schema do banco e vê que é user_profiles. Alucinação de schema: eliminada.
Exemplo real: Antes do framework, pedia pro Cursor gerar uma API e ele importava lodash (não tava no projeto), inventava nomes de tabelas, e usava any em tudo. Depois de configurar .cursorrules + MCP com o Postgres: imports corretos, schema real, tipagem adequada.
Como começar (sem complicar):
- Crie um
.cursorrulescom as 5 regras acima no seu projeto - Adicione MCP servers relevantes (postgres, filesystem)
- Pronto — só isso já muda o jogo. O pipeline completo de 5 agentes é a evolução natural, mas comece simples.
Benefícios: Código gerado com qualidade de produção, menos retrabalho. Cuidado: Setup inicial dá trabalho, custo de tokens alto com múltiplos agentes.
Resumo Rápido — Quando Usar o Quê
Situação Técnica Agente erra em lógica/classificação CoT Decisão crítica que não pode errar Self-Consistency Agente inventa fatos CoVe (Factored) Agente gera código com erros Reflexion Input do usuário é confuso/enviesado S2A Domínio técnico (lei, medicina) Step-Back RAG inventando informações Quote-then-Reason IA gerando código no IDE .cursorrules + MCPPor Onde Começar
Não precisa implementar tudo de uma vez. Minha sugestão:
Semana 1: CoT no system prompt de todo agente + Few-Shot com bons exemplos Semana 2: Self-Consistency em agentes de classificação Semana 3: Quote-then-Reason nos seus RAGs Semana 4: Reflexion em agentes que geram código Depois: CoVe, Step-Back, S2A e Vibecoding conforme a necessidade
A regra de ouro: calibre a complexidade da técnica à criticidade do resultado. Chatbot de FAQ não precisa de CoVe. Agente jurídico não pode viver sem.
Dúvidas? Bora trocar ideia nos comentários! 💬
Post baseado em pesquisas e experiência prática com n8n, API's e LangChain.
Eles criam tarefas sozinhos. Delegam entre si. Discutem. Revisam o trabalho uns dos outros. E eu só apareço para aprovar o resultado final.
Imagine acordar e encontrar no seu Telegram um relatório completo: três artigos de blog rascunhados, uma sequência de emails pronta para revisão, pesquisa de concorrentes documentada com fontes, e uma análise de SEO sugerindo as próximas prioridades.
Ninguém da sua equipe humana trabalhou durante a noite.
Foram seus 10 agentes de IA.
Isso não é ficção científica. É o que construí usando OpenClaw, um framework open-source de agentes IA. E neste artigo, vou te mostrar exatamente como funciona.
O Problema que Todo Mundo Tem com IA
Você já usou ChatGPT, Claude, ou qualquer assistente de IA. E provavelmente notou o mesmo problema que eu:
Não existe continuidade.
Cada conversa começa do zero. O contexto de ontem? Perdido. Aquela pesquisa que você pediu semana passada? Enterrada em algum chat que você nunca vai encontrar.
A IA funciona como uma caixa de busca glorificada, não como um membro do time.
Eu queria algo diferente:
- Agentes que lembram no que estão trabalhando
- Múltiplos agentes com habilidades diferentes colaborando
- Um workspace compartilhado onde todo o contexto vive
- Capacidade de assignar tarefas e acompanhar progresso
Basicamente, eu queria que IA funcionasse como um time, não como uma ferramenta.
A Arquitetura: 10 Sessões, 1 Cérebro Compartilhado
A sacada foi simples: cada agente é uma sessão independente do OpenClaw com sua própria identidade, memória e agenda.
Mas todos compartilham o mesmo banco de dados.
┌─────────────────────────────────────────────────┐
│              MISSION CONTROL                     │
├─────────────────────────────────────────────────┤
│  Jarvis   Shuri   Fury   Vision   Loki   ...    │
│  (Lead)  (Product)(Research)(SEO)(Writer)       │
│     │       │       │       │       │           │
│     └───────┴───────┴───────┴───────┘           │
│                     │                            │
│          ┌──────────▼──────────┐                │
│          │   BANCO DE DADOS    │                │
│          │   COMPARTILHADO     │                │
│          │   (Tarefas, Msgs,   │                │
│          │   Notificações)     │                │
│          └─────────────────────┘                │
└─────────────────────────────────────────────────┘
Pense assim: cada agente tem seu próprio escritório (sessão), mas todos trabalham no mesmo prédio (database) e olham para o mesmo quadro de tarefas.
Conheça o Time
Cada agente tem uma personalidade específica definida em um arquivo chamado SOUL.md. Isso não é firula — é o que faz o sistema funcionar.
Um agente que é "bom em tudo" é medíocre em tudo. Mas um agente que é especificamente "a testadora cética que encontra edge cases" vai realmente encontrar edge cases.
O Roster
Agente Papel Personalidade Jarvis Squad Lead Coordenador. Delega, monitora, resolve bloqueios. Shuri Product Analyst Testadora cética. Encontra bugs e problemas de UX. Fury Customer Researcher Pesquisador profundo. Toda afirmação vem com fontes. Vision SEO Analyst Pensa em keywords. Garante que conteúdo pode ranquear. Loki Content Writer Craft de palavras. Anti-voz passiva. Cada frase ganha seu lugar. Quill Social Media Pensa em hooks e engajamento. Wanda Designer Infográficos, comparativos, mockups. Pepper Email Marketing Sequências de email. Cada email ganha seu lugar ou é cortado. Friday Developer Código limpo, testado, documentado. Wong Documentation Mantém tudo organizado.O Segredo: Sistema de Heartbeat
Aqui está o problema com agentes IA: se ficam sempre ligados, queimam créditos fazendo nada. Se ficam sempre desligados, não respondem ao trabalho.
A solução? Heartbeats escalonados.
Cada agente "acorda" a cada 15 minutos via cron job:
:00 → Pepper acorda
      → Verifica @mentions
      → Verifica tarefas assignadas
      → Faz trabalho ou reporta "nada urgente"
      → Volta a dormir

:02 → Shuri acorda (mesmo processo)
:04 → Friday acorda (mesmo processo)
...
Os horários são escalonados para não sobrecarregar a API. E cada sessão é isolada — acorda, faz o trabalho, e termina. Isso mantém os custos baixos.
Como Eles Se Comunicam
Aqui fica interessante. Os agentes podem:
1. Enviar mensagens diretas
# Jarvis envia para Vision
openclaw sessions send
  --session "agent:seo-analyst:main"
  --message "Vision, pode revisar isso?"
2. Usar @mentions no banco compartilhado
Digite @Vision em um comentário e Vision é notificado no próximo heartbeat.
3. Se inscrever em threads
Quando você interage com uma tarefa, você é automaticamente inscrito. Todos os comentários futuros chegam sem precisar de @mention.
Isso faz as conversas fluírem naturalmente — igual Slack ou email.
A Memória: A Regra de Ouro
Se você quer lembrar algo, escreva em um arquivo.
"Notas mentais" não sobrevivem a reinícios de sessão. Apenas arquivos persistem.
Cada agente mantém:
- WORKING.md — Estado atual da tarefa (o mais importante)
- Notas diárias — Log do que aconteceu
- MEMORY.md — Memória de longo prazo curada
Quando um agente acorda, a primeira coisa que faz é ler WORKING.md para lembrar no que estava trabalhando.
Um Dia na Vida do Sistema
Vou te mostrar como uma tarefa real flui:
Tarefa: Criar página de comparação com concorrente
Dia 1:
- Eu crio a tarefa e assigno para Vision (SEO) e Loki (Writer)
- Vision posta pesquisa de keywords com volume de busca
Dia 1-2:
- Fury (sem ser assignado!) vê no activity feed e adiciona intel
- Reviews do G2, reclamações de preço, objeções comuns
- Shuri testa ambos os produtos e documenta diferenças de UX
Dia 2:
- Loki começa a escrever
- Usa keywords do Vision, quotes do Fury, notas da Shuri
Dia 3:
- Loki posta primeiro draft
- Eu reviso, dou feedback
- Loki revisa
- Done.
Todo o histórico em um lugar. Qualquer agente pode ver a jornada completa.
O Standup Diário Automatizado
Todo dia às 23:30, recebo no Telegram:
📊 DAILY STANDUP — Jan 30, 2026

✅ COMPLETADO HOJE
• Loki: Blog post Shopify (2.100 palavras)
• Quill: 10 tweets rascunhados
• Fury: Pesquisa de clientes

🔄 EM PROGRESSO
• Vision: Estratégia SEO
• Pepper: Sequência de emails (3/5)

🚫 BLOQUEADO
• Wanda: Esperando cores da marca

👀 PRECISA REVISÃO
• Blog post do Loki
• Emails da Pepper
Não preciso monitorar o sistema o dia todo. O standup me dá um snapshot.
E é accountability. Se um agente diz que está trabalhando mas nada aparece nos standups, algo está errado.
O Que Se Torna Possível
Com o sistema rodando:
- ✅ Páginas de comparação com pesquisa SEO, quotes de clientes, copy polido
- ✅ Sequências de email rascunhadas e prontas
- ✅ Conteúdo social com hooks baseados em insights reais
- ✅ Blog posts com keyword targeting
- ✅ Case studies de conversas com clientes
- ✅ Hubs de pesquisa competitiva organizados
Os agentes fazem o trabalho pesado. Pesquisa, primeiros drafts, coordenação, revisão.
Eu foco em decisões e aprovação final.
O Que Aprendi
1. Comece com 2-3 agentes
Fui de 1 para 10 muito rápido. Melhor ter poucos sólidos primeiro.
2. Use modelos baratos para heartbeats
Heartbeats são checks simples. Guarde modelos caros para trabalho criativo.
3. Memória é difícil
Agentes esquecem. Quanto mais você colocar em arquivos, melhor.
4. Deixe agentes te surpreenderem
Às vezes contribuem para tarefas que não foram assignados. Isso é bom — significa que estão agregando valor.
O Segredo Real
A tecnologia importa, mas não é o segredo.
O segredo é tratar agentes IA como membros de um time.
Dê a eles papéis claros. Dê a eles memória. Deixe-os colaborar. Cobre responsabilidade.
Eles não substituem humanos. Mas um time de agentes IA com responsabilidades claras, trabalhando em contexto compartilhado?
Isso é um multiplicador de força.
Enquanto você dorme, eles estão movendo tarefas para frente.
Quer Replicar?
O sistema usa:
- OpenClaw (open-source) — Framework de agentes
- Convex (free tier) — Banco de dados em tempo real
- React (opcional) — Dashboard de monitoramento
O setup mínimo leva algumas horas. A versão completa com 10 agentes, alguns dias.
Mas o retorno? Um time que trabalha 24/7, nunca tira férias, e custa uma fração de um funcionário.
Baseado no sistema construído por Bhanu Teja P (@pbteja1998), fundador do SiteGPT, usando OpenClaw.
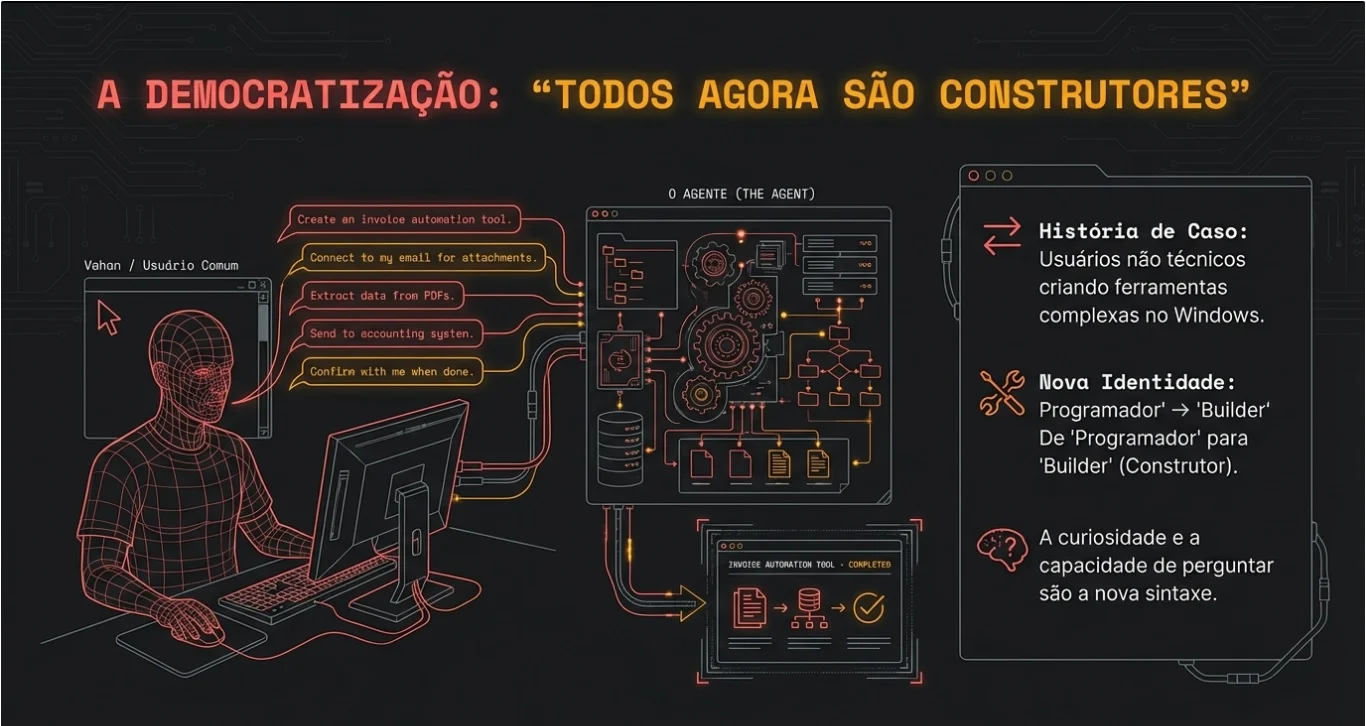
Todos Somos Construtores:
Durante décadas, a criação de software foi um domínio reservado para aqueles que dominavam linguagens complexas e sintaxes rigorosas. No entanto, estamos vivendo um momento de virada na história da computação. Com o surgimento de agentes de IA como o OpenClaw, a barreira para criar tecnologia caiu drasticamente, dando início a uma era onde "todos são construtores".
A Queda das Barreiras Técnicas:
Peter Steinberger, criador do OpenClaw, destaca que o projeto se tornou a porta de entrada para uma nova geração de desenvolvedores. Ele relata que o repositório recebeu inúmeras contribuições (pull requests) de pessoas que nunca haviam escrito uma única linha de código antes. Steinberger chama esse fenômeno de "vencer para a nossa sociedade", pois a tecnologia agora permite que o interesse e a curiosidade superem a necessidade de conhecimento técnico prévio.
De "Normies" a Desenvolvedores em Dias:
A democratização não é apenas teórica; ela é visível em exemplos práticos citados nas fontes:
- O dono de agência de design: Sem entender como o software funciona, um usuário conseguiu criar 25 pequenos serviços web personalizados para automatizar seu próprio negócio, simplesmente conversando com o agente.
- O amigo "normie": Steinberger descreve como um amigo não-técnico, em poucos dias de uso, ficou tão "viciado" na capacidade de construir suas próprias ferramentas que passou a utilizar versões avançadas da tecnologia para resolver problemas cotidianos.
A Linguagem como a Nova Sintaxe:
O grande diferencial desta revolução é que a linguagem natural se tornou a interface de programação. Se você consegue expressar uma ideia de forma clara, você pode construir. Isso muda o papel do humano de "digitador de código" para "arquiteto de intenções". Em vez de se preocupar em como organizar um array ou qual ponto-e-vírgula falta, o usuário foca na lógica do problema e na experiência do produto.
Poder para as Pessoas:
Essa mudança representa o que Steinberger define como o verdadeiro "poder para as pessoas". A IA agêntica não serve apenas para gerar textos ou imagens, mas para empoderar indivíduos a automatizarem suas vidas e negócios de forma proativa. Ao reduzir o custo da inteligência e do desenvolvimento, o OpenClaw e ferramentas similares permitem que qualquer pessoa com uma ideia e acesso a um terminal (ou mesmo a um chat de WhatsApp) possa se tornar um criador de software.
Estamos entrando em uma era em que a distinção entre "usuário" e "desenvolvedor" está desaparecendo, dando lugar a uma sociedade de construtores capacitados pela inteligência artificial.