
Blindagem de Tokens em Orquestra de Agents: como reduzimos ~60% a 70% no OpenClaw sem perder performance
Se você opera automações com multi-agents, já sabe: token é dinheiro e limite de provider pode parar operação do nada.
A boa notícia é que dá pra reduzir consumo de forma agressiva sem desmontar qualidade.
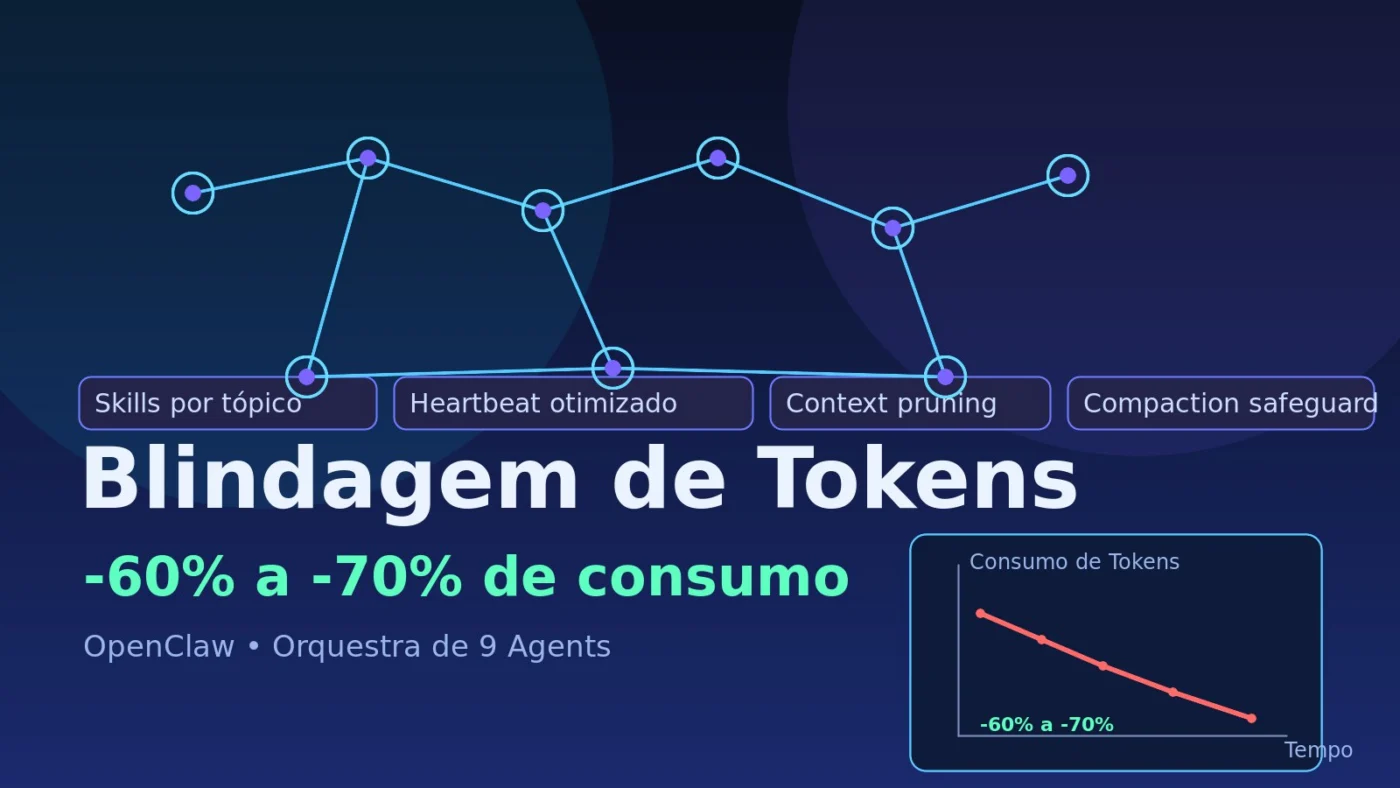
Neste case, aplicamos blindagem em uma orquestra com 9 agents no OpenClaw e consolidamos uma redução real de ~60% a ~70% no consumo/contexto operacional.
Cenário inicial
Orquestra com 9 agents especializados (main + 8 secundários), com:
• alto volume de contexto injetado por turno,
• risco de crescimento silencioso de consumo,
• e exposição a travas de rate limit.
Nosso objetivo foi criar uma camada de proteção que funcionasse mesmo se o cenário “grátis” mudar.
O que mais queimava tokens
Mapeamos 5 vazamentos principais:
- Bootstrap pesado em todo turno (AGENTS.md, MEMORY.md grandes).
- Skills demais para quem não precisava delas.
- Heartbeats desnecessários em agents secundários.
- Histórico de grupo alto aumentando contexto injetado.
- Ausência de blindagem mais rígida de contexto (pruning + compaction).
O que aplicamos (na prática)
-
Compressão de arquivos estáticos (sem perder regra crítica)
• AGENTS.md (main): 8.9KB → 2.2KB (-76%)
• MEMORY.md (main): 6.7KB → 1.5KB (-77%)
Detalhes pesados foram movidos para arquivo de referência sob demanda (memory/infra-credenciais.md), em vez de ficar injetando tudo sempre.
-
Skills por especialidade/tópico (escopo mínimo)
Em vez de deixar “tudo para todos”, cada agent/tópico ficou só com o necessário:
• Sentinel → infra/healthcheck
• Catalyst → marketing/growth
• Chroma → design/copy
• Scribe → docs/pdf
• Archivist → sem skills extras (só tools nativos)
Para Nexus/Orion (uso por spawn), a regra foi fixada em AGENTS.md do workspace:
“Use apenas estas skills.” -
Heartbeat com governança
• Secundários: 0m (desativado)
• Main: ativo
• Janela ativa: 08:00–23:00 (BRT)
Isso removeu chamadas automáticas com baixo retorno e reduziu ruído operacional.
-
Blindagem de contexto no sistema
Aplicamos no config:
• contextPruning: cache-ttl (5m)
• compaction: safeguard + memoryFlush
• thinkingDefault: low
• historyLimit: 30 (grupo/telegram)
• bootstrapTotalMaxChars: 12000
Tradução prática: menos inchaço, menos repetição inútil e mais previsibilidade de custo.
-
Continuidade sem inflar prompt (amnesia-proof)
Regra de log obrigatório com evidência:
data/hora - ocorrência - ação - status - persiste? - evidênciaCom isso:
• diário em memory/YYYY-MM-DD.md,
• e consolidação de decisões permanentes em MEMORY.md.
Memória durável sem virar “lixo caro” no prompt.
Resultado consolidado
Economia real estimada (conservadora)
• Main: ~2.9k tokens a menos por turno (só em bootstrap comprimido)
• Agents de tópico: ~3k a ~4k tokens a menos por turno (com skills filtradas)
• Operação total: ~60% a ~70% de redução no consumo/contexto
Lições para quem roda automação com IA
- Prompt bonito não substitui arquitetura.
- Blindagem real vem de config/sistema, não de “frases de rate limit” no system prompt.
- Escopo mínimo por agent é um dos maiores ganhos de custo.
- Heartbeat sem propósito vira sangria de token.
- Token economy é disciplina de engenharia.
Checklist rápido (replicável)
• [ ] Comprimir AGENTS.md e MEMORY.md
• [ ] Mover detalhes pesados para memória sob demanda
• [ ] Filtrar skills por agent/tópico
• [ ] Cortar heartbeat onde não gera valor
• [ ] Definir janela de heartbeat
• [ ] Ativar pruning + compaction safeguard
• [ ] Reduzir historyLimit de grupos
• [ ] Formalizar protocolo amnesia-proof com evidência
Conclusão
Se você opera multi-agents em produção, otimizar token não é “nice to have”.
É sobre sobrevivência operacional, previsibilidade de custo e continuidade de entrega.
Blindar agora é o que evita apagar incêndio depois.