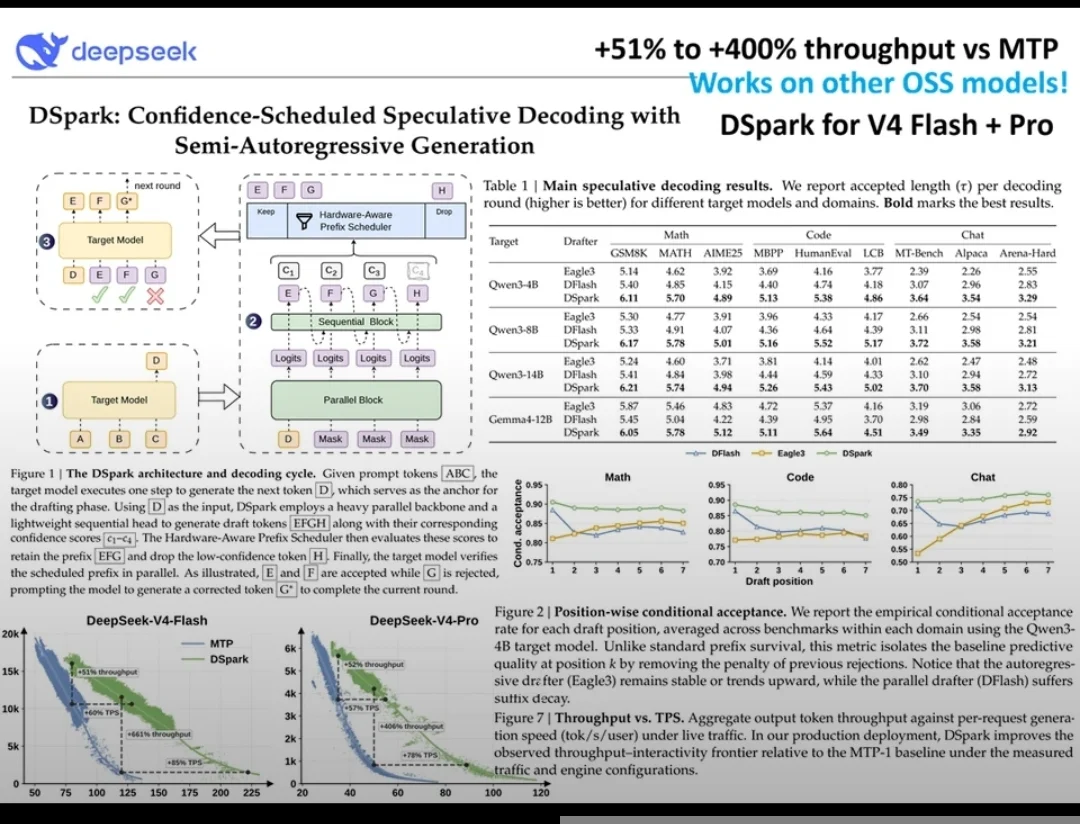

DeepSeek lança DSpark - decodificação de especificações 50%-600% mais rápida em comparação ao MTP
A DeepSeek lança o DSpark para V4 Flash & Pro, um novo método de decodificação especulativa que aumenta a produção de 51% a 400% em comparação com um único MTP!
A DeepSeek também mostrou que o DSpark funciona bem para outros modelos OSS, como Gemma e Qwen, em seu artigo de pesquisa.
Eles também compararam com o Eagle3 e DFlash, e mostraram que o DSpark tem um desempenho melhor também!
Links
- Github: https://github.com/deepseek-ai/DeepSpec
- Paper: https://github.com/deepseek-ai/DeepSpec/blob/main/DSpark_paper.pdf
- Hugging Face Model: https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro-DSpark
---
Resumindo o que é DSpark:
É uma técnica de "decodificação especulativa" da DeepSeek pros modelos V4 Flash e V4 Pro. Em vez de gerar 1 token por vez igual ao MTP padrão, ele consegue gerar muito mais rápido - entre 51% e 400% a mais de tokens/segundo. E pelo paper, funciona também em modelos abertos tipo Gemma e Qwen, batendo Eagle3 e DFlash.