
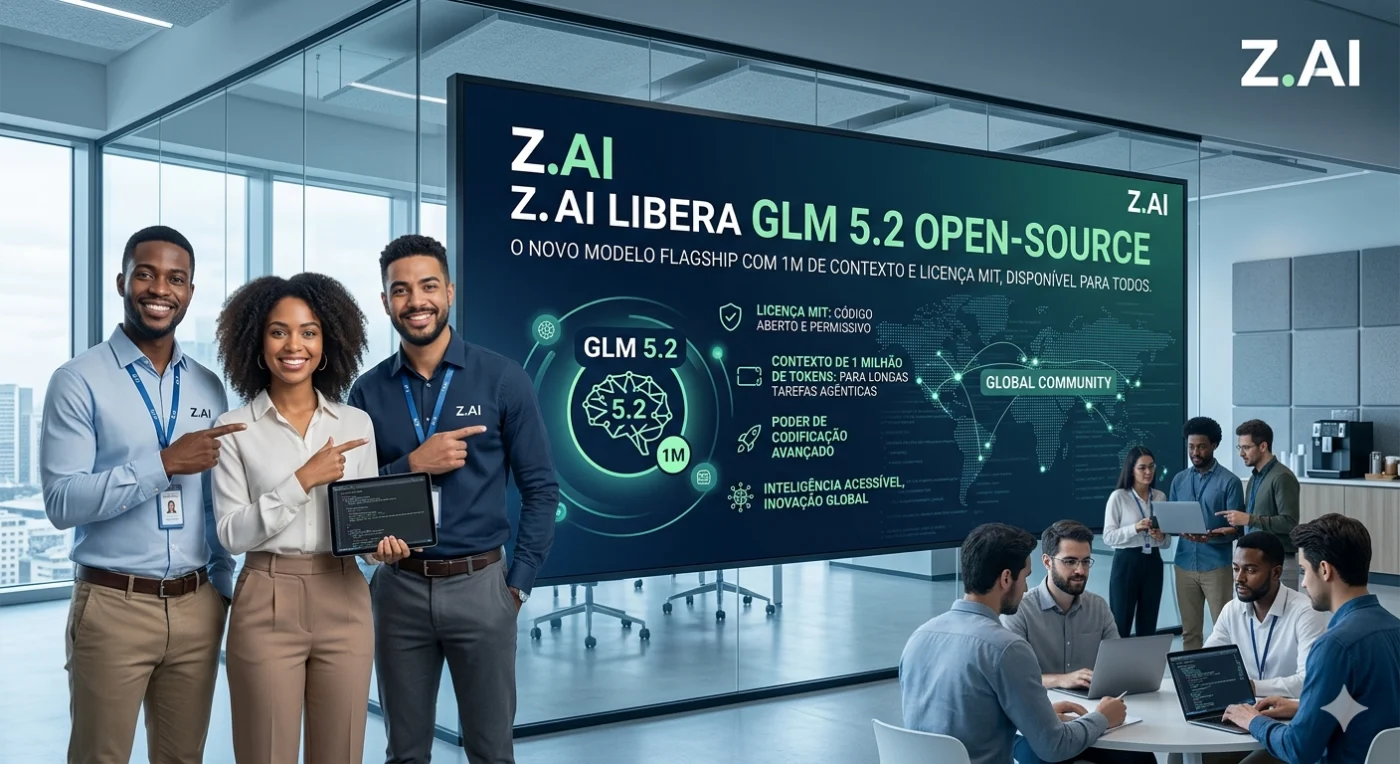
Para desenvolvedores: o GLM-5.2 agora está totalmente aberto, a inteligência de ponta pertence a todos.
Em um momento em que alguns modelos de ponta se tornam repentinamente indisponíveis, escolhemos acreditar em outro caminho: a inteligência de ponta não deve pertencer apenas a alguns, nem deve ser retirada a qualquer momento por algumas regras. Deve ser aberta, utilizável, construível e servir a todos os desenvolvedores.
GLM-5.2 é o modelo open-source mais poderoso da Zhipu até o momento, suportando um contexto realmente utilizável de 1M e mantendo sua liderança em tarefas de longo alcance. Também continua sendo o modelo de codificação doméstico mais forte em nossos corações.
Hoje à noite, às 17:21, o GLM-5.2 estará aberto a todos os usuários do Plano de Codificação GLM, cobrindo as edições Lite / Pro / Max / Team.
A API do GLM-5.2 estará disponível na próxima semana, e o modelo será oficialmente open-source na próxima semana sob a licença MIT.
Um passo mais perto da inteligência de ponta para todos. O futuro da IA é aberto, e é para o povo.
ModelKey: GLM-5.2
🚀 OmniRoute v3.8.23 chegou!
Mais uma release recheada, lançada hoje (13/06). Destaques abaixo:
🔗 Releases: https://github.com/diegosouzapw/OmniRoute/releases
✨ v3.8.23 — Novidades
🧠 Auto-Combo com inteligência dinâmica (Arena ELO + models.dev)
Acabou a lista estática de fitness. O Auto-Combo agora usa uma cadeia de 5 camadas para pontuar modelos em tempo real:
- Override do usuário
- Score de ELO do Arena AI Leaderboard
- Tiers do models.dev
- Mapa hardcoded (fallback)
- Neutro (fallback final)
A pipeline sincroniza scores automaticamente — seus combos ficam melhores conforme o ranking muda, sem configurar nada.
📊 Vertex AI: descoberta dinâmica de modelos
O provider vertex agora consulta a Generative Language API em runtime para expor o catálogo completo da conta: modelos de imagem (Imagen, gemini-*-image), embeddings e modelos parceiros — não mais a lista hardcoded reduzida.
Além disso: rastreamento próprio de gasto USD na página de Limites, por conexão Vertex, com base em custo de tokens.
🔒 Model Lockout: UI completa com recuperação automática
- Tela de configuração para habilitar/desabilitar e ajustar limiares
- Success-decay: modelo bloqueado se recupera gradualmente conforme chamadas bem-sucedidas acumulam
- Aplicado a todos os providers quando habilitado
🗂️ Modos de visualização da página de Providers
Nova opção de 3 estados: All (todos os providers) / Configured (só os com conexão) / Compact (configurados em layout condensado).
💰 API Keys: drilldown de custo + % de quota usada
A página de API Keys agora mostra breakdown de custo por chave e o percentual de quota consumido por cada uma.
⚙️ Outras novidades
- Gemini: metadados de rate-limit por modelo (ex: Gemma 4 = 15 RPM) — cooldown engine aplica corretamente
- Emergency budget fallback: opt-out via
OMNIROUTE_EMERGENCY_FALLBACK=false
🔧 Fixes importantes
- 🐛 MiMoCode 403 corrigido: o endpoint da Xiaomi exigia uma assinatura anti-abuso que o OmniRoute não enviava. Resolvido.
- 🔄 Loop de refresh OAuth fixado: um bug fazia o token tentar refresh a cada 60s — um caso chegou a 1.352 tentativas consecutivas em uma conta Claude. Corrigido.
- ⚡ Anthropic + VS Code: o Claude no VS Code envia
temperature+top_pjuntos. A API rejeita. OmniRoute agora removetop_pautomaticamente quandotemperatureestá presente. - 🌐 Qwen Web migrado para v2: a API legada (
/api/chat/completions) foi desativada upstream e retornava 504 HTML. OmniRoute migrou para o fluxo v2. - 🔑 Vertex AI Express-mode: aceita agora API keys no formato
AIza*além de JSON de Service Account. - 📦
omniroute setup opencode: novo comando CLI que instala o plugin opencode automaticamente. - 📡
/v1/messages/count_tokens: agora respeita o proxy configurado por conexão (antes ia DIRECT, vazando o IP). - 🤖 Stream combo: agora faz fallback em respostas vazias ou com filtro de conteúdo.
🔗 https://github.com/diegosouzapw/OmniRoute/releases/tag/v3.8.23
A inteligência artificial está revolucionando a criação de conteúdo, e uma das tecnologias mais impressionantes do momento é a síntese de voz. Entre as novidades que vêm ganhando destaque, o modelo GPT-4o Mini TTS (Text-to-Speech) oferece uma solução gratuita para converter textos em áudio com qualidade surpreendente.
O que é o GPT-4o Mini TTS?
O GPT-4o Mini TTS é um modelo de conversão de texto em fala desenvolvido pela OpenAI. Ele foi projetado para transformar textos escritos em áudio com voz natural, proporcionando uma experiência mais humana e agradável para ouvintes. O modelo recebe texto como entrada e gera áudio como saída.
A versão gratuita disponibilizada pela plataforma NagaAI permite que desenvolvedores, criadores de conteúdo e empresas experimentem a tecnologia sem custos iniciais.
Principais Vantagens
1. Voz Natural e Fluida
Diferente dos sintetizadores tradicionais, o GPT-4o Mini TTS produz falas mais naturais, reduzindo aquele efeito robótico comum em soluções antigas.
2. Ideal para Diversas Aplicações
A tecnologia pode ser utilizada em:
- Assistentes virtuais
- Leitura de artigos e notícias
- Sistemas automotivos
- Conteúdo para redes sociais
- Audiobooks
- Atendimento ao cliente
- Acessibilidade digital
3. Facilidade de Integração
A plataforma disponibiliza documentação e exemplos de código para integração via API, facilitando a implementação em projetos web e aplicativos.
Aplicações no Setor Automotivo
Para o universo automotivo, o GPT-4o Mini TTS abre oportunidades interessantes:
Assistentes de Bordo
Veículos conectados podem utilizar a tecnologia para fornecer informações de navegação, alertas e notificações por voz de forma mais natural.
Leitura de Informações do Veículo
Dados sobre manutenção, consumo e diagnósticos podem ser comunicados ao motorista através de uma voz mais agradável e intuitiva.
Experiência do Usuário
Montadoras e empresas de tecnologia automotiva podem criar interfaces de voz mais modernas, aproximando a interação homem-máquina de uma conversa real.
Como Acessar
O modelo pode ser encontrado na plataforma NagaAI:
GPT-4o Mini TTS Free na NagaAI
A página disponibiliza informações sobre capacidades, especificações e exemplos de utilização.
Considerações Finais
O GPT-4o Mini TTS representa mais um passo importante na evolução da inteligência artificial aplicada à comunicação por voz. Sua capacidade de gerar áudio natural, aliada à disponibilidade gratuita para testes e desenvolvimento, torna a solução especialmente atrativa para empresas, desenvolvedores e criadores de conteúdo.
No setor automotivo, onde a interação por voz ganha cada vez mais espaço, tecnologias como essa têm potencial para melhorar significativamente a experiência dos usuários, tornando veículos e sistemas conectados mais inteligentes, acessíveis e eficientes.
🚨 ALERTA MÁXIMO — Os modelos mais poderosos da Anthropic foram DESLIGADOS
Hoje (12/06), o governo dos EUA emitiu uma diretiva de controle de exportação citando segurança nacional e forcou a Anthropic a suspender TODO o acesso ao Claude Fable 5 e Mythos 5.
E não é só pro Brasil. É pra qualquer estrangeiro no mundo todo.
🔥 O quao pesado é isso?
A ordem bloqueia o acesso de:
- ❌ Qualquer cidadão estrangeiro — dentro OU fora dos EUA
- ❌ Até funcionários da própria Anthropic que sejam estrangeiros
- ❌ Brasileiros, europeus, asiaticos — TODOS cortados
A Anthropic foi obrigada a desligar abruptamente os dois modelos para todos os clientes pra garantir conformidade legal. O recado oficial saiu às 17h21 (ET) e o desligamento foi imediato.
“O efeito líquido dessa ordem é que precisamos desabilitar abruptamente o Fable 5 e o Mythos 5 para todos os nossos clientes.” — Anthropic
🤔 Por quê?
O governo alega ter tomado conhecimento de um método de “jailbreak” do Fable 5 ligado a cibersegurança. A própria Anthropic discorda fortemente:
- Diz que as vulnerabilidades são menores e já conhecidas
- Afirma que outros modelos públicos (incluindo o GPT-5.5 da OpenAI) encontram as mesmas falhas sem precisar de jailbreak
- Classifica a ação como um “mal-entendido” e diz estar trabalhando para restaurar o acesso
✅ Importante: Os demais modelos Claude (Opus, Sonnet, Haiku) NÃO foram afetados e seguem funcionando normalmente.
💣 O PRECEDENTE PERIGOSO
Essa é a parte que você precisa entender:
🔴 Se o governo dos EUA pode desligar um modelo de fronteira do dia pra noite por segurança nacional — o que impede de fazerem o mesmo com outros modelos?
🔴 Hoje foi o Fable 5. Amanhã pode ser Opus, GPT, Gemini?
🔴 Isso abre uma porta perigosa: e se o acesso à IA de ponta ocidental virar privilégio só de americanos?
🔴 Será que vamos precisar migrar para modelos chineses (DeepSeek, Qwen, Kimi) como alternativa estratégica?
Pode não acontecer. Mas o precedente foi aberto hoje. E quem trabalha com automação e IA precisa ficar de olho.
📅 A sexta-feira mais maluca do ano
Em um único dia:
- 📱 Meta caiu (Instagram, Facebook, WhatsApp)
- ☁️ AWS com instabilidades
- 🧠 Anthropic banida pelo próprio governo dos EUA
📰 Fontes oficiais
- Comunicado oficial Anthropic: https://www.anthropic.com/news/fable-mythos-access
- Twitter/X oficial @AnthropicAI: https://x.com/AnthropicAI/status/2065597531644743999
⚠️ Compartilhe com a galera. Quem depende de IA pra trabalhar precisa saber disso AGORA.
🚀 OmniRoute v3.8.22 chegou!
Três versões importantes em poucos dias. Veja os destaques:
🔗 Releases: https://github.com/diegosouzapw/OmniRoute/releases
✨ v3.8.22 — Novidades
🆓 MiMoCode — Novo provider gratuito da Xiaomi
Novo provider sem autenticacao, modelo mimo-auto com 1 milhao de tokens de contexto. Suporta multiplas contas com round-robin e retry automatico. 100% gratuito.
📓 Obsidian / WebDAV integrado
Servidor /api/v1/webdav para sincronizar seu vault do Obsidian Mobile diretamente via OmniRoute, autenticado e seguro.
🧠 Preferencia Claude Code para IDs claude-* nao prefixados
Opt-in: rotas automaticamente IDs claude-* genericos pelo Claude Code OAuth sem precisar de prefixo.
📜 Historico de chamadas Codex WebSocket
Chamadas /v1/responses via WebSocket agora sao persistidas no historico.
🔧 Toggle de conta direto no card de quota
Desativa/ativa uma conta sem sair da tela.
📦 v3.8.21 — Fixes de routing
- Modelos de reasoning (DeepSeek v4, Nemotron) nao retornavam conteudo em combo routing — corrigido
/v1/completionsretorna agora o formato correto do OpenAI Completions (quebrava TabbyML)omniroute autostartganhou:on/off/toggle/status- Fix quota z.ai/GLM Coding Plan: nao mostrava mais 0% incorretamente
🌟 v3.8.20 — Claude Fable 5 e Resiliencia
- Claude Fable 5 (
claude-fable-5) — 1M context, 128k output, fallback chain automatico - Cooldown global de provider apos falha em combo (backoff exponencial 5s – 5min)
- Threshold do breaker de degradacao agora configuravel em Settings
🚨 Meta fora do ar no Dia dos Namorados!
Na manhã desta sexta-feira (12/06), usuários de todo o Brasil e do mundo relataram instabilidade em Instagram, Facebook e WhatsApp — todos pertencentes à Meta.
As falhas começaram por volta das 10h40 e incluem:
- ❌ Não conseguir acessar a conta
- ❌ Feed não carrega
- ❌ Stories não abrem
- ❌ Não consegue postar fotos ou vídeos
- ❌ Contas deslogadas automaticamente
- ❌ App abre mas não carrega conteúdo
📊 Proporção
O site Downdetector registrou dezenas de milhares de reclamações em poucos minutos. Usuários migraram em massa para o X (antigo Twitter) para confirmar se a queda era generalizada — e era.
🔍 Status oficial
Até o momento da publicação, a Meta não se manifestou oficialmente sobre a causa da instabilidade nem deu previsão de normalização.
⚠️ Evite:
- Tentar trocar senha desnecessariamente
- Reinstalar o app sem motivo
- Fazer várias tentativas de login seguidas
Acompanhe o status oficial em: https://metastatus.com
📰 Fontes
- CNN Brasil: https://www.cnnbrasil.com.br/tecnologia/instagram-e-facebook-apresentam-instabilidade-nesta-sexta-feira/
- Times Brasil / CNBC: https://timesbrasil.com.br/brasil/instagram-apresenta-instabilidade-nesta-sexta-feira-usuarios-relatam-falhas-de-acesso/
- Portal Tempo Novo: https://www.portaltemponovo.com.br/instagram-e-facebook-fora-do-ar-e-usuarios-relatam-instabilidade/
- Status oficial Meta: https://metastatus.com
💥 Update: Downdetector também caiu!
A queda da Meta foi tão massiva que o Downdetector — o próprio site usado para monitorar quedas — ficou instável e fora do ar. A sobrecarga de usuários tentando confirmar o problema derrubou a ferramenta de monitoramento.
🚀 Isso é sério. 68.300 estrelas em menos de 2 semanas.
O Odysseus é um workspace de IA self-hosted completo — pensa num ChatGPT/Claude rodando 100% na sua máquina, sem nenhum dado saindo pro servidor de ninguém.
🔗 GitHub: https://github.com/pewdiepie-archdaemon/odysseus
🔗 Site: https://pewdiepie-archdaemon.github.io/odysseus/
📦 O que tem dentro
- 💬 Chat & Agentes — conversa multi-turn + agentes autônomos com ferramentas (bash, arquivos, web, memória)
- 🔧 MCP nativo — conecta qualquer servidor MCP que você já usa
- 🍳 Cookbook — escaneia seu hardware, recomenda modelos compatíveis e baixa com um clique (270+ modelos catalogados, GGUF / FP8 / AWQ)
- 🔬 Deep Research — pesquisa em múltiplas etapas, lê fontes e monta um relatório sintetizado automaticamente
- 📧 E-mail com IA — triagem, resumo, rascunho de resposta no seu estilo, anti-spam — via IMAP/SMTP
- 📅 Calendário — sincroniza via CalDAV (Nextcloud, Apple, Fastmail)
- 📝 Editor de documentos — você escreve, a IA ajuda quando você pedir
- 🧠 Memória persistente — o agente lembra de você e evolui a cada conversa (ChromaDB)
- 🎭 Compare — manda o mesmo prompt pra vários modelos e compara as respostas lado a lado
- 📱 Funciona no celular — PWA installável, responsivo
⚡ Instalação em 3 comandos (Docker)
git clone https://github.com/pewdiepie-archdaemon/odysseus.git
cd odysseus
docker compose up -d --build
Abre em http://localhost:7000. Na primeira vez ele gera uma senha de admin no terminal.
🔐 Privacidade de verdade
- Sem telemetria
- Todos os dados ficam em
data/na sua máquina - Autenticação habilitada por padrão
- Licença AGPL-3.0 (código aberto de verdade)
Para quem já usa N8N, Evolution API, Dify ou qualquer stack open-source — esse é o frontend de IA que faltava rodar junto. Vale muito o teste! 👀
Saiu mais uma atualização do OpenClaw! A versão 2026.6.5 traz melhorias em MCP, canais, provedores e segurança.
🔢 Novo esquema de versões
A partir dessa release o OpenClaw adota o formato YYYY.M.PATCH — facilita identificar o mês de cada versão. Esta é a primeira sob a nova numeração.
✨ Destaques
🧠 MCP mais estável
Resultados de ferramentas MCP com conteúdo não suportado (resource_link, audio, imagens malformadas) são convertidos antes de chegar nos provedores — fim dos erros 400 da Anthropic e históricos corrompidos.
🗨️ QQBot sem thinking vazando
O QQBot remove as tags de raciocínio antes de entregar a resposta. Usuários só vêem a resposta final.
🔁 Anthropic Extended-Thinking mais resiliente
Sessões se recuperam após expiração de prompt-cache ou restart do Gateway.
🔍 Parallel como provedor de busca nativo
Configure PARALLEL_API_KEY e o Parallel aparece automaticamente no seletor de busca.
📂 Skills via ClawHub (GitHub)
Instale skills direto de repos GitHub — commit pinado, integridade validada, telemetria incluída.
🔒 Auth e plugins mais seguros
Perfis de auth migram para SQLite. Ferramentas HTTP só podem ser usadas pelo dono.
📱 Mobile Android
Provedores expirando ou indisponíveis aparecem mais claramente. Seleção de tema adicionada.
💬 Matrix e canais
Preflight de voz e preservação de threads via paginação de relations.
🔗 Links
- Release: github.com/openclaw
- npm: npmjs.com
#openclaw #agenteIA #MCP #automacao #opensource
Qual vcs usam mais?
Análise com carinho e escolha qual caminho percorrer. Quer rápido e com eficiência? Ou com eficiência e velocidade?